A股逐笔数据质量怎么评估?从实时订阅到历史明细对账
TickDB Research ·
A股逐笔数据质量怎么评估?从实时订阅到历史明细对账
接口返回成功、字段齐全、成交价看起来正常,是否就意味着逐笔数据可以直接用于历史分析?还不够。同一条成交在两次查询里可能更换 ID,方向字段可能出现约定之外的值,最近 1,000 条也未必覆盖整个交易日。
本文以中际旭创、新易盛、宁德时代的实际成交明细查询为例,把数据质量拆成可执行的检查,并说明如何将实时订阅落库与历史回查连接起来。本次实查完成于 2026 年 10 月 13 日晚间;实测对象是最近成交窗口,没有完成盘中 WebSocket 采集,也没有取得任意历史日期的全日逐笔。
先定义“历史明细”到底是什么
实时订阅回答“连接期间收到哪些记录”;最近成交查询回答“当前可返回的最近 N 条是什么”;按日期检索的历史逐笔回答“指定日期、指定区间的记录是否齐全”。三者不能互相替代。
本次查阅的 REST 文档提供 symbol、limit、type 参数,limit 最大为 1,000,没有列出日期范围或分页游标。因此,这里的历史分析分为两层:实际回查最近成交窗口;设计将实时消息持续落库,逐日形成可追溯历史。不能为前一种接口虚构 start、end 或 cursor 参数,也不能因为没有查到某项参数,就断言服务的所有产品均不提供历史逐笔。
更细的一层是“逐笔”的来源粒度:一条接口记录是否对应一笔交易所原始成交,是否由快照差分、合并或其他处理得到,需要单独确认。只有字段名和记录条数,无法证明它是交易所完整逐笔流。
用三只活跃标的建立样本
选取当日成交活跃的三只创业板股票作为案例。连接器快照显示,中际旭创、新易盛、宁德时代的当日累计成交额分别约为 221.13 亿、146.14 亿、119.07 亿元。这只是样本选择依据,不是我们对全市场重新计算的热度排名;三个样本也不能代表所有 A 股板块。
对每只股票调用一次最近成交查询,limit=1000,并保存原始响应。下面的时间全部转换为北京时间,日期均为 2026-10-13。
| 标的 | 样本起止时间(各 1,000 条) | unknown 方向记录 |
|---|---|---|
| 中际旭创 300308.SZ | 14:08:51—15:30:00 | 35 条 / 3.5% |
| 新易盛 300502.SZ | 14:09:12—15:30:00 | 42 条 / 4.2% |
| 宁德时代 300750.SZ | 14:08:24—15:30:00 | 26 条 / 2.6% |
三份样本中,price、quantity、timestamp、side 均未发现空值,价格与数量均为正数;按响应顺序没有发现时间倒退,单份响应内没有重复 ID。这些都是样本内的检查结果,不能据此给出全日完整率或“零丢包”的结论。
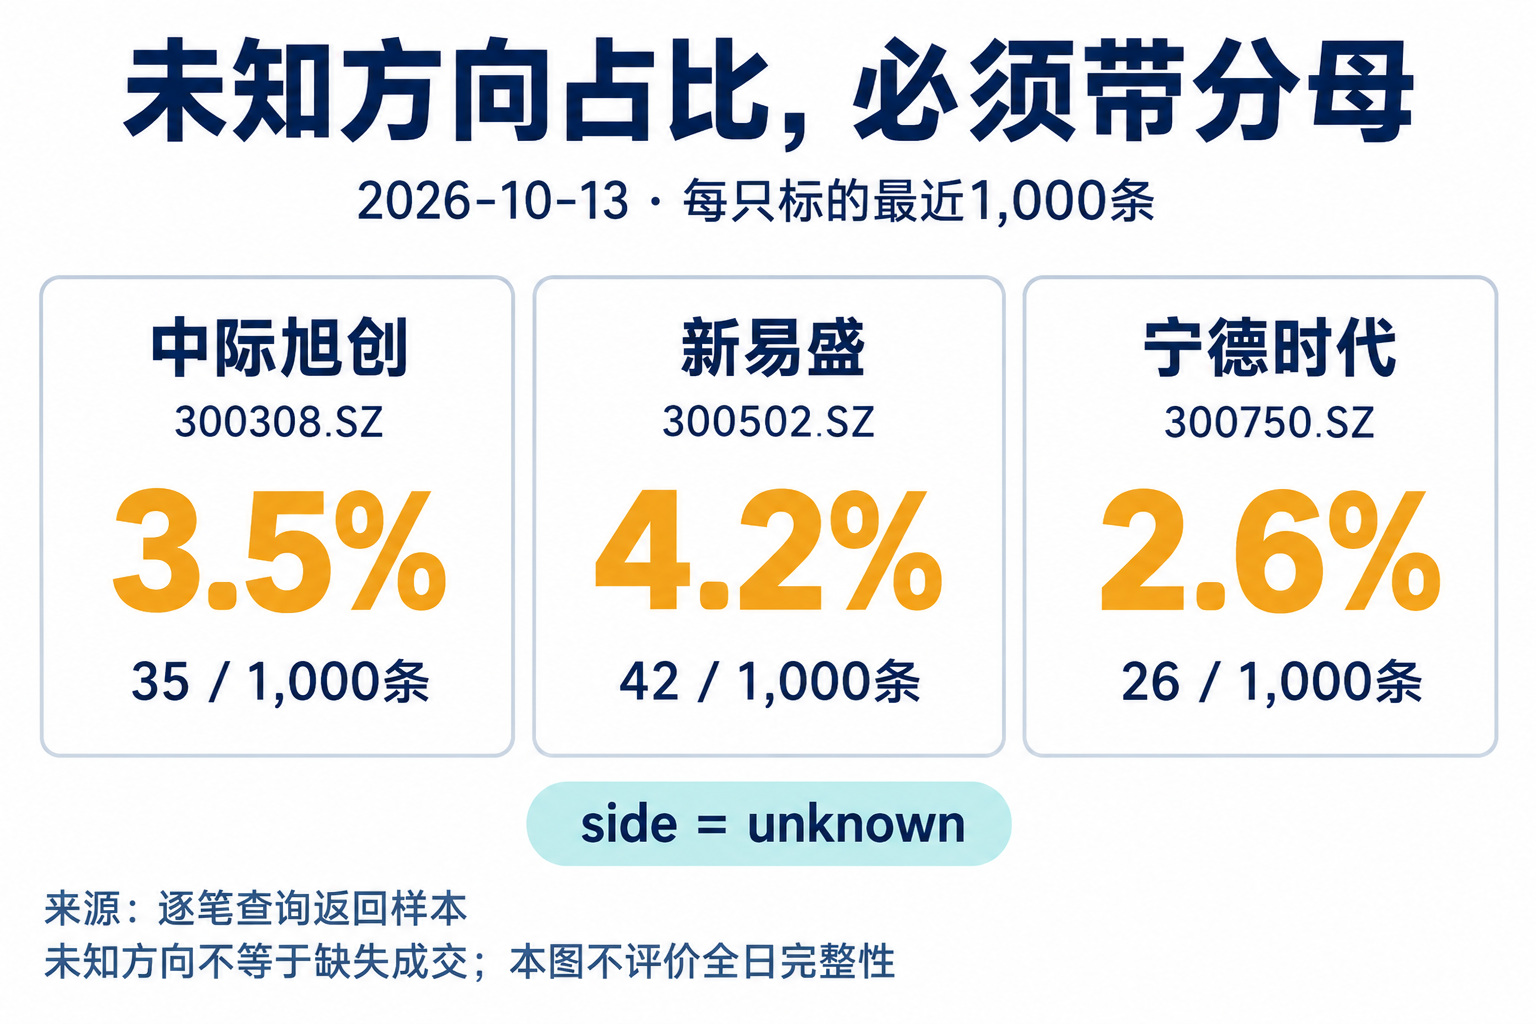
图 1:2026-10-13 的最近查询窗口中,中际旭创、新易盛、宁德时代的 unknown 方向分别为 35/1,000、42/1,000、26/1,000。未知方向不等于缺失成交,这些比例不能用于评价全日完整性。
维度一:字段有效,业务含义也要成立
文档将成交方向列为 buy、sell、neutral,实际返回却还出现 unknown。严格按三种枚举解析的客户端可能报错;把 unknown 自动转为 neutral,又会把“未知”改成“中性”,改变分析口径。
建议保留 side_raw,把无法解释的方向标记为未知。计算方向占比时同时报告未知率;需要方向的计算仅使用已知方向记录,并明确分母。本文中的 3.5%、4.2%、2.6% 都以各自 1,000 条为分母。buy/sell 的判定方法也需核实,不能直接解释成真实资金流入流出。
数量字段同样不能只验证“能转成整数”。已读取的逐笔页面只写了“成交数量”,没有说明 A 股 quantity 的单位。本次原始数量合计分别是 37,323、52,721、69,111,但在确认“股、手或其他单位”之前,不将其写成成交股数或计算成交金额。更不能拿这段尾部窗口的数量除以全天快照成交量,称为数据完整率。
价格还有一个容易忽略的细节:原始响应存在 734.1199951171875 这样的长小数。按 0.01 网格检查,三份样本分别有 859、929、953 条不恰好落在网格上。这与浮点表示误差的表现相符,但仅凭响应不能确定服务内部实现。
处理时保留原字符串,使用 Decimal 计算;展示值可以按已核实的价格档位处理,原值不要覆盖。Decimal 能避免继续引入二进制浮点运算误差,不能恢复上游已经损失的精度。自动四舍五入也不应掩盖真正的异常报价。
维度二:时间合法,不等于粒度正确
三份样本的相邻记录对各有 999 组,其中间隔恰好 3 秒的分别为 963、956、972 组,占 96.40%、95.70%、97.30%。这种明显节奏值得进一步确认上游采样或聚合方式。
这不是“3 秒延迟”的测量,也不能由此断言每 3 秒只发生一笔交易。当前只有事件时间,没有实时接收时间、交易所序列和独立完整参考流。将这些记录直接用于订单流重建或逐笔微观结构回测,证据不足。
同时,不应把 15:00 后的记录一律认作脏数据。深交所《交易规则(2026 年修订)》规定了 15:05—15:30 的盘后固定价格交易时段。本次三份样本分别有 36、43、27 条时间晚于 15:00;时间规则应结合证券、日期和会话判定。交易规则能说明盘后时段存在,不能单独证明每条返回记录都是真实且分类正确的盘后成交。
实时采集时至少分别保存 event_ts 和 received_at。二者相减只能称为“观测到的数据年龄”,其中还包含时钟偏差、上游处理和本地排队;未做时钟校准和链路拆分时,不应称为纯网络延迟。盘后执行历史查询时,请求时间减成交时间更不能当作实时延迟。
维度三:ID 在单次响应内唯一,跨窗口是否稳定?
对中际旭创再发起 limit=100 的查询,结果中的 100 条成交内容与前一份 1,000 条响应的尾部完全一致,但对应 ID 全部不同。
例如,时间戳为 1791874431000、价格为 734.1199951171875、数量为 20、方向为 sell 的记录,在大窗口中的 ID 是 1791874431000_900,在小窗口中变为 1791874431000_0。这是本次两个查询窗口的观察,不能外推成所有市场、所有日期的 ID 生成规则。
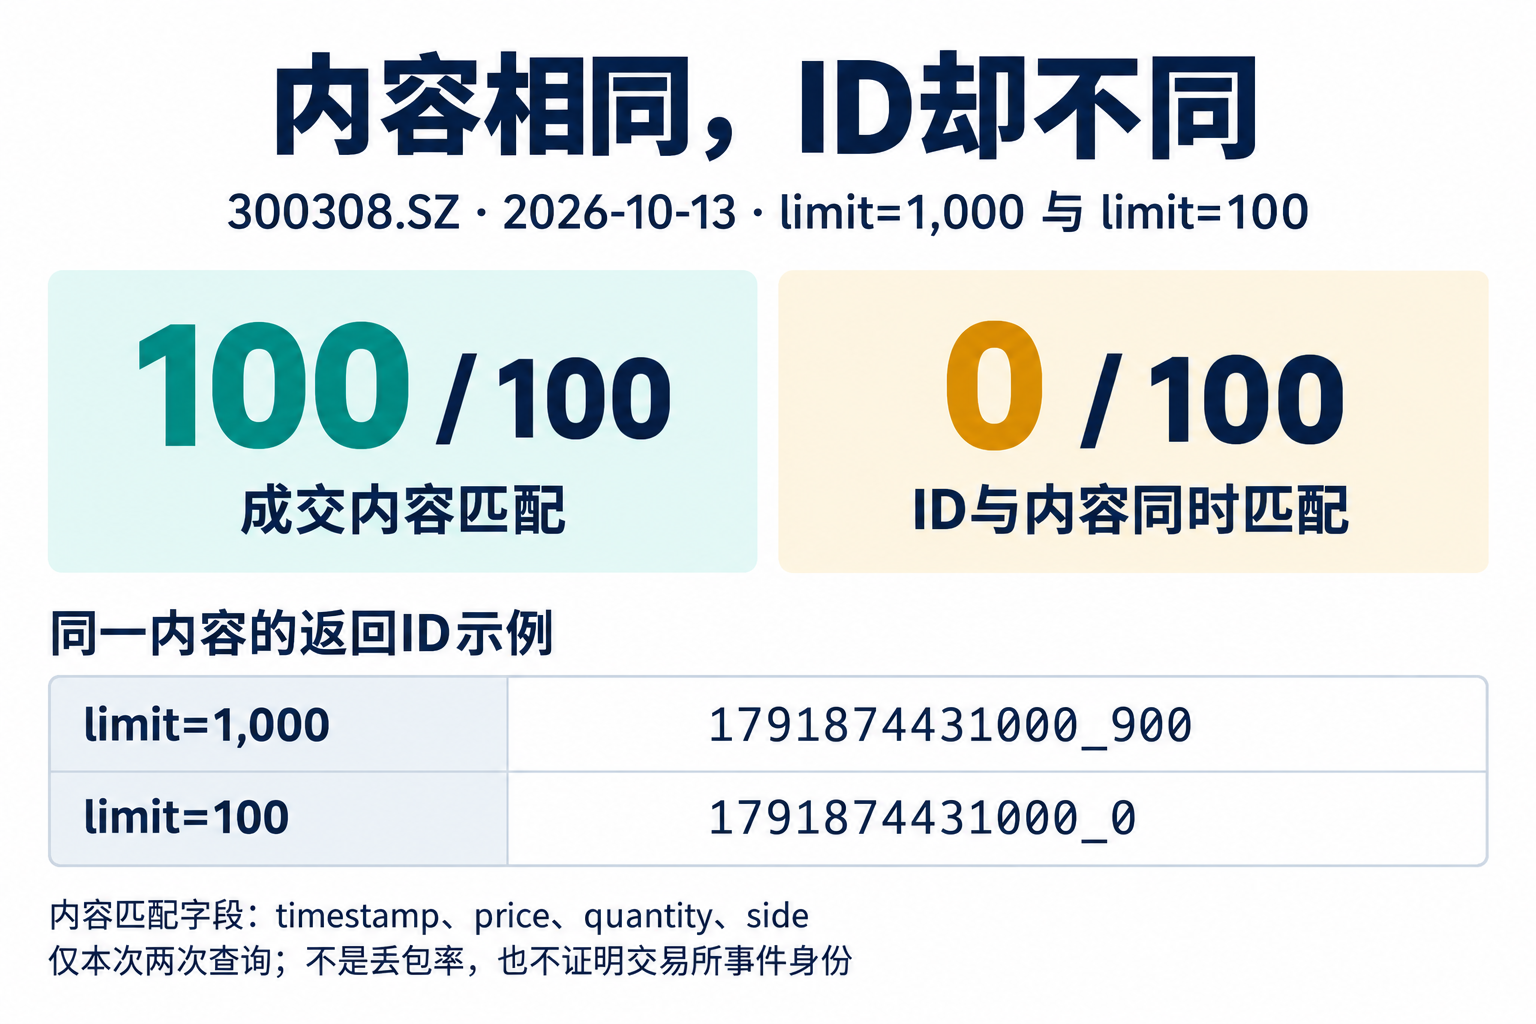
图 2:本次 300308.SZ 的两次查询中,100/100 条成交内容匹配,0/100 条 ID 与内容同时匹配。示例 ID 分别为 1791874431000_900 和 1791874431000_0。内容按 timestamp、price、quantity、side 对比;该结果不是丢包率,也不能证明交易所事件身份。
工程上的直接影响是:如果用 id 做跨请求主键,轮询或回补后可能把同一内容重复计入;如果只用时间戳做主键,又可能覆盖同一毫秒内的合法成交。
可先用“证券 + 时间戳 + 价格 + 数量 + 方向”做诊断指纹,以多重集合比较出现次数,而不是直接 set 去重。不同真实成交仍可能拥有相同指纹,因此指纹只能帮助对账,不能替代稳定的交易所事件标识。原始层保留请求批次、连接会话及消息序号;存在歧义的记录留待核查,不静默删除。
把观察写成能复跑的检查
下面是最近窗口的请求示例,按本次读取的官方快速开始使用 X-API-Key。需要有效密钥及相应行情权限;本次真实查询通过连接器完成,下面这条 curl 命令未在本机直接执行。
curl --fail-with-body --get \
  'https://api.tickdb.ai/v1/market/trades' \
  -H "X-API-Key: ${MARKET_API_KEY}" \
  --data-urlencode 'symbol=300308.SZ' \
  --data-urlencode 'type=stock' \
  --data-urlencode 'limit=1000' \
  -o recent-1000.json
再将 limit 改为 100,保存为 recent-100.json。以下 Python 代码比较两份成功响应,以 Decimal 保留十进制数值含义,以 Counter 保留相同内容的出现次数。它是诊断代码,不会修改或去重原始记录。
import json
from collections import Counter
from decimal import Decimal

def read(path):
    with open(path, encoding="utf-8") as f:
        obj = json.load(f)
    if obj.get("code") != 0:
        raise ValueError("Request failed")
    return obj["data"]["trades"]

def key(r):
    return (r["timestamp"], Decimal(r["price"]),
            Decimal(r["quantity"]), r["side"])

a = read("recent-1000.json")
b = read("recent-100.json")
x, y = Counter(map(key, a)), Counter(map(key, b))
print("payload overlap:", sum((x & y).values()))
x = Counter((r.get("id"), key(r)) for r in a)
y = Counter((r.get("id"), key(r)) for r in b)
print("id + payload overlap:", sum((x & y).values()))
对本次保存的两个原始响应提取业务 JSON 后执行,输出分别为 100 和 0。若盘中执行,两次查询之间窗口会前移,应先确认重叠时间范围;较低的重叠数本身不能证明丢失。附件脚本还会统计字段、方向、乱序、重复内容和价格网格异常。
从实时订阅建立可核查的历史
本次核实的实时地址与订阅消息如下。A 股 trade 消息的单笔字段直接位于 data,不能照搬港美股 data.trades 数组的解析方式;文档中的 A 股消息示例也没有可供跨端匹配的 id。这部分已核对文档,未完成在线订阅实测。
import os
from urllib.parse import urlencode

ws_url = "wss://api.tickdb.ai/v1/realtime?" + urlencode({
    "api_key": os.environ["MARKET_API_KEY"]
})
subscription = {
    "cmd": "subscribe",
    "data": {"channel": "trade",
             "symbols": ["300308.SZ", "300502.SZ", "300750.SZ"]}
}
# Pass ws_url and subscription to a WebSocket client.
# Do not print ws_url: it contains a credential.
实际落地时,先保存完整原始消息和接收时间,再生成标准记录。连接成功不等于订阅成功,应记录订阅反馈及首条数据;重新连接后重新订阅,并记录断线区间。原始层与分析层分开,解析失败或未知枚举可以隔离处理,但不能直接丢弃。
历史分析按交易日和会话读取落库记录,先确认缺口,再计算逐分钟记录数、数量和价格统计。在窗口、单位、粒度、会话一致的前提下,比较实时落库与回查结果的记录多重集合;有稳定标识时再检查事件级覆盖。若以 B 为参考窗口、A 为本地窗口,诊断匹配率可以写为 sum(min(A[k], B[k])) / sum(B[k]),但它只是“相对参考窗口的匹配率”。B 也可能缺数据,不能因此称为市场真实完整率。
断线回补尤其受最近 N 条上限约束:如果回查最早时间已经晚于断线开始,说明该窗口不足以验证整个断线区间。应标记不可验证区间,使用已确认的历史数据渠道补足,或排除该区间的完整性敏感分析。不能把重连成功当作历史自动补齐。
这批数据能给出什么结论
当前证据支持三类结论:样本字段与正值检查通过;方向枚举、价格精度表现和跨窗口 ID 稳定性需要适配或进一步核实;全日完整率、交易所原始逐笔粒度、实时数据年龄和实时—历史一致性尚未测得。
对于成交明细展示,这些记录可以用于检查解析与展示逻辑;对于数量、成交额或买卖方向分析,先确认单位与方向定义;对于逐笔回测与订单流分析,还必须取得粒度、完整性和事件身份的证据。数据质量的验收结果应落在具体用途上:哪些检查已经通过,哪些统计受限,哪些区间仍不可验证。