Yahoo Finance API迁移指南:先对齐旧数据,再决定怎么换股票API
TickDB Research ·
摘要:面向已有Yahoo Finance或yfinance股票原型、正在评估换源的金融应用产品负责人,本文用价格口径、日期记录、数值差异、页面功能和切换条件五步,判断旧图表能否保留。解释关闭自动调整后仍含拆股调整、行数相同却缺日期等容易误判的问题,提供可读取旧新CSV的完整Python工具、对照页面及验收表,把差异变成可处理的事项。
原型里的自选列表和日线图已经能用,团队准备评估新的股票API。最棘手的问题往往出现在两份数据放在一起之后:同一只股票,历史价格不同;两边都有20行,日期却对不上。此时该修改转换代码、补取数据,还是保留原方案?
先确认两份数据是否具有可比条件,再逐条对齐,最后检查差异对页面功能的影响。TickDB股票快照和历史K线可以作为候选数据入口;把来源差异收进一层明确的转换代码,产品负责人才能看到哪些功能已经有依据保留,哪些还需要处理。
一、换源前,先给差异找到正确的位置
迁移可以按下面五步推进,每一步都有具体产物。
| 步骤 | 要回答的问题 | 应留下的结果 |
|---|---|---|
| 价格口径 | 同名字段是否表示同一种价格 | 旧、新设置与定义记录;暂不可比的原因 |
| 日期记录 | 哪些股票和日期只出现在一边 | 单侧缺失、重复记录及预期日期检查 |
| 数值差异 | 可比较的记录,具体哪列不同 | 按列列出的差值,保留原值 |
| 页面功能 | 差异会怎样影响现有页面 | 修复、延后或保留功能的处理单 |
| 切换条件 | 哪些问题解决后才能推进 | 明确的决定、负责人和回退办法 |
不要一开始就把所有差异归为数据质量问题。设置不同、记录未对齐、数值确有差异,需要不同的处理方式。
二、最容易误判的一项:关闭自动调整,OHLC仍可能包含拆股调整
yfinance当前价格调整文档说明:auto_adjust=True会调整OHLC;设为False时,返回的OHLC仍是Yahoo已做拆股调整的序列,并另带包含分红调整的Adj Close。
因此,旧脚本的auto_adjust=False,不能仅凭名字就与新接口的“不复权”视为相同。TickDB本例查询使用adjust="none",其含义按该接口定义核对,不能直接拿两个选项名称作等价映射。
这会影响历史图表的判断。Apple在2020年公告4拆1,并安排8月31日起按拆股调整基础交易。如果产品需要展示这类事件前后的历史,验收就应包含相应区间,而不能只看一段没有跨越事件的近期样本。本篇没有取得该事件区间的两源行情,不展示其一致性结果。
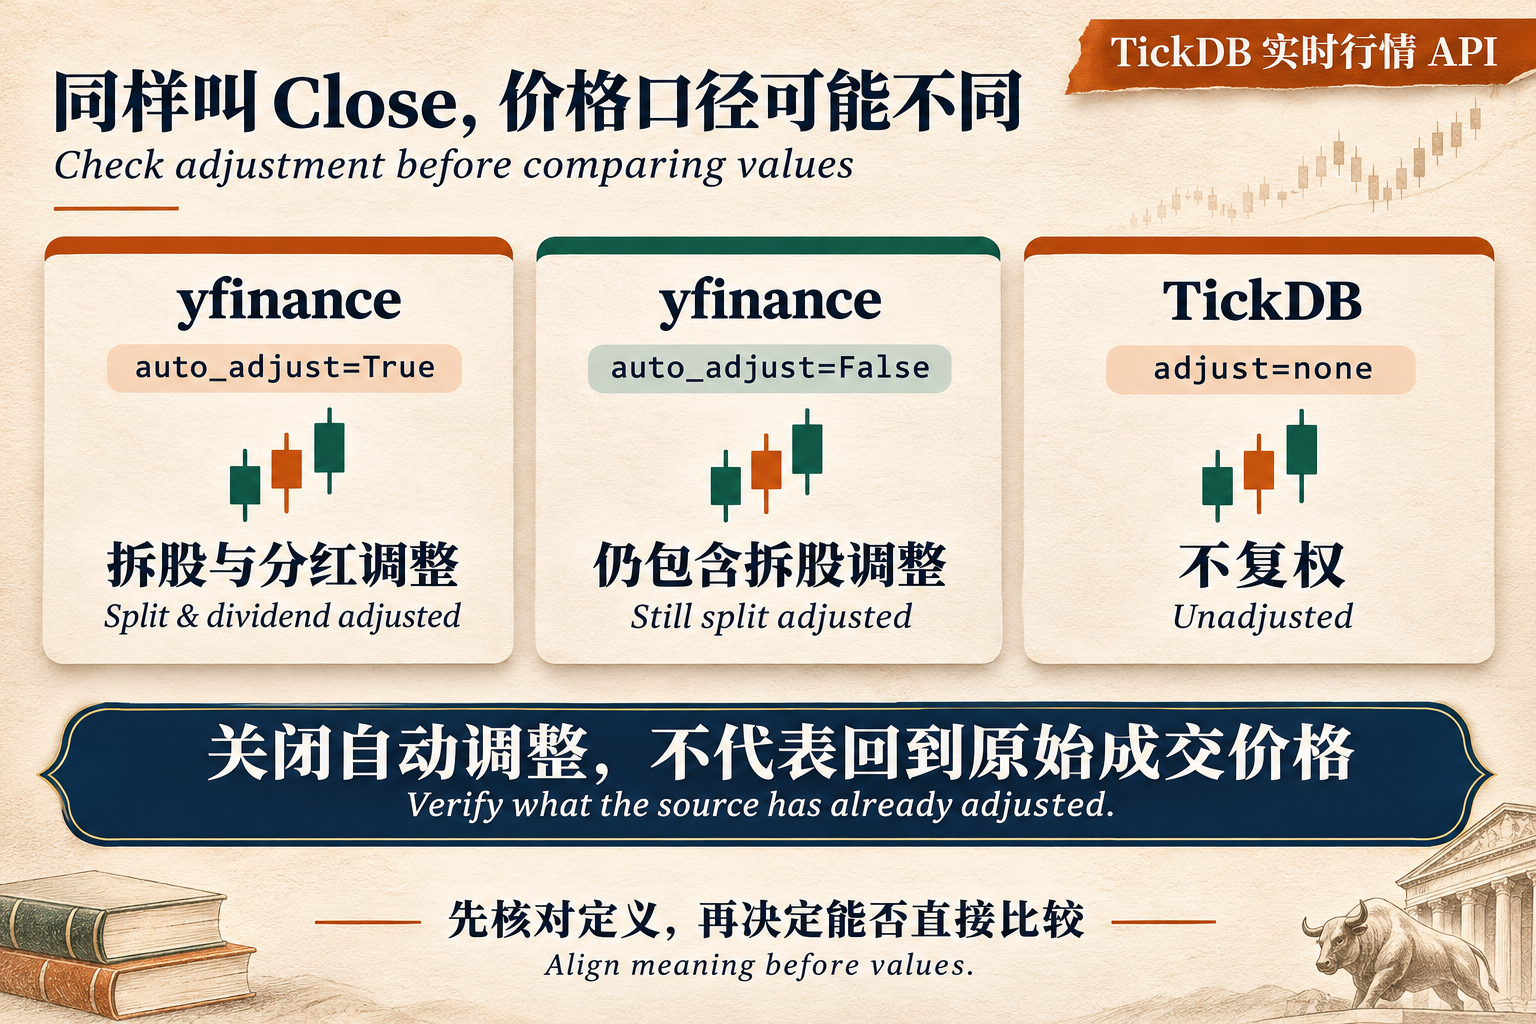
图1:AI概念示意,依据资料定义解释价格处理方式;图中的K线形状不代表真实价格或两源对齐结果。
保存旧设置,比重新猜一次更有用
旧CSV可能经过了调整、修复或缺失值处理。保留原文件,再记录实际运行版本和参数。
| 旧方案记录项 | 为什么会影响迁移判断 |
|---|---|
auto_adjust、字段定义 | 影响OHLC与调整后价格的含义 |
repair及后续处理 | 旧结果可能经过修复或重构,不能当作未经处理的原始值 |
start、end与实际日期 | yfinance的end为排他边界,结束日不要凭输入文字推断 |
keepna与自行删行逻辑 | 影响缺失记录是否仍留在表中 |
prepost、时区与日期标签 | 影响交易阶段及日期怎样对应 |
| 导出时间、库版本、代码版本 | 帮助复现当时结果,而非依赖今天的默认设置 |
这些设置以自己的脚本为准。新数据也记录周期、币别、交易阶段、调整方式和日期定义。尚未确认的地方写“未知”,先比较覆盖情况,暂不判断价格一致性。
三、两边都是3行,仍然可能漏数据
下面的工具只比较日线OHLC;实时报价需要另按价格对象、事件时间和交易阶段核对,不能把不同步的快照直接判为价格不一致。
下面用一个可运行的合成软件测试案例解释对齐过程。代码中的DEMO_A不是证券,日期清单和数值均为测试输入;它没有使用Yahoo或TickDB行情。
旧表含01-05、01-06、01-08,新表含01-05、01-07、01-08;测试要求的日期另列为01-05至01-09。两边行数都是3,但问题并没有消失。
| 测试日期 | 程序结果 | 产品负责人应追问什么 |
|---|---|---|
| 01-05 | 两边数值一致 | 这行可进入后续功能检查 |
| 01-06 | 仅旧表有 | 新侧原始记录、日期标签或缺失处理需要核对 |
| 01-07 | 仅新表有 | 旧侧是否有提取或过滤缺口 |
| 01-08 | 数值有差异 | 哪一列不同,设置与数据依据能否解释 |
| 01-09 | 两边都缺 | 预期清单是否正确;若应有数据,为什么共同缺失 |
测试中01-08的close从11变为11.05,程序输出close:0.05。这是一条需要调查的差异,不自动解释为供应商错误,也没有预设“相差1%以内就通过”。
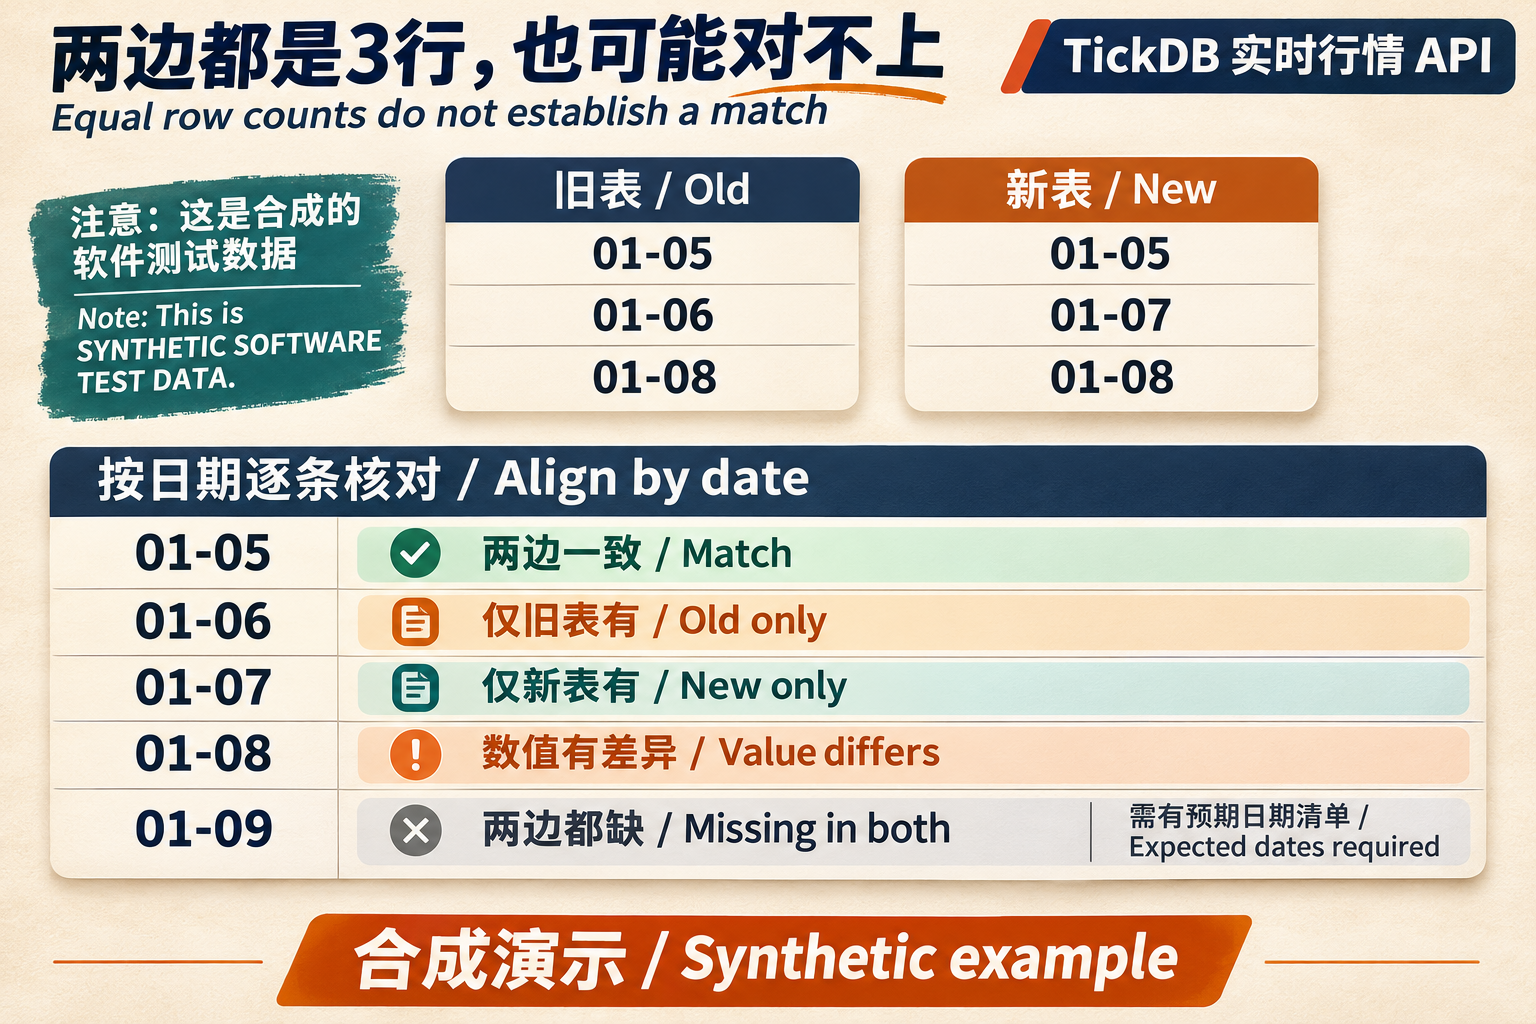
图2:AI概念示意,内容对应合成测试输入。实际软件输出另保存为CSV、JSON和可打开的HTML对照页。
先核对两边是否都具备同一条记录
用明确的证券身份与交易日期匹配,保留两边的记录并集。只比较共同出现的行,会把单侧缺失藏起来;重复键则要先处理,避免错误地一行匹配多行。
两边共同缺少的日期,需要第三份“预期记录清单”才能发现。它应来自核对过的交易日与产品覆盖要求;交易所日历是起点,个股暂停交易等情况仍须另查。没有这份清单时,程序会写NOT_CHECKED,不会把两源一致称为历史完整。
可比条件没确认,先停在这里
工具会核对周期、币别、交易阶段、价格调整基础和日期定义,以及双方经过人工确认的可比范围。任一项未知或不同,匹配上的记录标为NOT_COMPARABLE,不计算价格差值。
配套还有一个独立的合成测试:一侧为拆股调整、一侧为不复权。它能列出日期覆盖,但会要求先对齐含义。真实使用时应核对或转换数据,不能只改配置标签让检查放行。
四、拿到结果后,怎样作出决定?
前面的合成案例已得到:1条一致、1条仅旧表有、1条仅新表有、1条数值差异、1条共同缺失。
它对应的决定是继续核对,暂不批准切换。具体工作可以这样分配:
| 发现 | 下一动作 | 本轮对功能的决定 |
|---|---|---|
| 日期覆盖不同 | 核对原始文件、过滤与日期定义,必要时重新提取 | 历史图表继续验证,不用补零掩盖缺口 |
| 对应记录有数值差异 | 记录差异列,核查调整和来源定义 | 保留差异,尚不判断哪一方正确 |
| 预期日期两边都缺 | 先审查预期清单,再调查数据缺口 | 暂不称历史区间完整 |
| 当前仅完成离线数据比较 | 在测试页面展示结果,检查标签与缺失状态 | 数据结果进入功能测试,仍待页面验收 |
如果某个必需功能缺少数据,先调整接入或交付范围;如果只是非必需功能未完成,可以明确延后。即使样本中没有差异,也要继续验收持续接收、实际展示用途及回退。
Google SRE的发布验证方法强调代表性范围和用户可感知的指标;AWS渐进替换资料讨论保留旧路径的回退思想。用于行情迁移时,可以落实为:先验证一个功能、保留可控切换方式、写清停止条件,再扩大范围。不必为了一个小原型照搬复杂架构。
五、真实样本:五天收盘展示值相同,开盘价为何有尾差?
这次取 AAPL 的2026年11月2—6日做一个小范围核对。旧侧使用搜索工具读取到的 Yahoo 官方历史页展示值,新侧使用 TickDB REST 返回的日线,参数为 interval=1d、adjust=none。Yahoo 查询接口在当前环境连接超时,因此这个案例不称为 yfinance 实际导出迁移。
TickDB在2026年11月11日16:00 UTC返回20根日线,本例选择其中的五日,保留其他原始记录。两侧证券代码分别为 AAPL 与 AAPL.US,整理后按日期并列如下,金额单位均为美元:
| 日期 | Yahoo展示开盘价 | TickDB原值开盘价 | Yahoo展示收盘价 | TickDB原值收盘价 |
|---|---|---|---|---|
| 11月2日 | 342.67 | 342.67 | 338.32 | 338.32 |
| 11月3日 | 325.58 | 325.58 | 331.90 | 331.9 |
| 11月4日 | 341.57 | 341.565 | 349.51 | 349.51 |
| 11月5日 | 353.89 | 353.89 | 344.17 | 344.17 |
| 11月6日 | 338.73 | 338.73 | 342.37 | 342.37 |
按这五个日期标签,两侧都有记录,收盘展示数值相同。11月4日的开盘价值得单独看:网页为 341.57,API原值为 341.565,两者相差 0.005 美元。这里能看到显示位数不同,尚不能据此判断哪家数据错了。
如果产品决定统一显示两位小数,可以明确采用一种显示策略。例如下面按 ROUND_HALF_UP 演示:
from decimal import Decimal, ROUND_HALF_UP

raw_open = "341.565"
display_open = Decimal(raw_open).quantize(Decimal("0.01"), rounding=ROUND_HALF_UP)
print(display_open)  # 341.57
这是应用自己的显示选择,不是对 Yahoo 内部舍入方式的确认。保存和计算仍保留原值;显示结果相同,也不能反推底层价格序列等价。
对照工具为什么没有给出“一致”结论?
把真实输入交给文中的原版比较器,得到的是:
NOT_COMPARABLE: 5
ALIGN_METADATA_BEFORE_VALUES
HUMAN_REVIEW_REQUIRED
原因没有被改标签掩盖:Yahoo历史页的价格带有拆股调整定义,TickDB本例选择不复权;两侧交易阶段和日线聚合日期的共同定义尚未确认,也没有还原原脚本的实际导出设置。比较器因此保留日期匹配结果,停在价格可比性检查。
这次已经可以作出一项具体的产品处理:报价或图表展示明确小数位和舍入策略,保留原值与来源;历史序列迁移继续等待口径确认。尚未执行实际页面切换,不把样本展示值相同当作上线批准。
这个案例的作用,是把“数据对不上”拆成能处理的问题:先分清展示与原值,再查价格口径,最后决定功能能否保留。实际接手已有原型时,还应导入自己的旧CSV与当时参数,按相同方法继续核对。
来源:Yahoo Finance的AAPL官方历史页可读快照、TickDB本次REST返回及交易日历。Yahoo来源为公开网页展示值,TickDB为接口原始返回;本例不是两侧API同时取样,也不是供应商准确率排名。
准备核对自己的接入条件时,可查阅TickDB股票API页面,再按实际功能选择样本。
六、运行工具,得到自己的对照结果
比较工具使用Python 3.10或更新版本及标准库,不联网,也不会修改输入文件。将文末代码保存为compare_migration.py,先运行合成演示:
python3 compare_migration.py --demo --out compare_runs
输出目录包括:
| 文件 | 用途 |
|---|---|
row_comparison.csv | 查看旧值、新值、单侧缺失、重复与差异 |
comparison_report.json | 查看可比条件、输入摘要和下一步结论 |
comparison_view.html | 用浏览器打开,查看对照结果与待核设置 |
程序也会生成用于演示的两份CSV、元信息和预期日期文件,均标为合成数据。
换成自己有权使用的导出文件
真实输入先整理为单层表头:
symbol,trade_date,open,high,low,close
trade_date须为已核对含义的YYYY-MM-DD交易日期,不能直接截取一个尚未解释的UTC时间。旧、新文件分别保存,原始导出不覆盖。元信息模板记录各自来源、设置、明确的代码映射及确认依据;semantics_reviewed只有在实际核对后才设为true,comparability_id引用双方同一份可比性确认记录。
元信息可从下面的结构开始,分别保存为old.meta.json与new.meta.json,再按各自实际情况填写。默认未知项会阻止数值比较:
{
  "source": "填写实际来源与版本",
  "interval": "1d",
  "currency": "unknown",
  "session": "unknown",
  "adjustment_basis": "unknown",
  "date_basis": "unknown",
  "comparability_id": "unknown",
  "semantics_reviewed": false,
  "symbol_map": {
    "AAPL": "AAPL.US"
  }
}
然后运行:
python3 compare_migration.py --old old.csv --new new.csv --old-meta old.meta.json --new-meta new.meta.json --expected expected.csv --out compare_runs
配套文件包含模板和原有TickDB取样程序。若自己还没有取得旧导出,先完成这一项;无需为了演示去下载不相关的全市场数据。
负责人最后保留一张功能验收单
| 功能 | 数据依据 | 尚未解决 | 决定与负责人 |
|---|---|---|---|
| 自选报价 | 股票身份、价格对象、来源与时间 | 所需时段、新鲜度及异常显示 | 填写 |
| 历史图表 | 对齐后的日期、OHLC与调整定义 | 缺口、差异及最后一根状态 | 填写 |
| 客户展示 | 实际受众、资料与使用条件 | 适用范围确认 | 填写 |
| 切换与回退 | 测试环境的执行记录 | 触发条件、来源标签及执行人 | 填写 |
先把一项功能的输入、差异和处理结果讲清楚,再决定是否扩大迁移。问题应收敛为“这项功能还缺什么依据”,这样技术和产品才知道下一步具体做什么。
新增案例核对:2026年11月12日(北京时间);方法资料核对:2026年11月11日。方法依据包括yfinance价格调整、下载参数与修复文档,pandas连接验证说明,Apple拆股公告,NYSE交易资料,以及Google SRE、AWS渐进替换方法。真实取样、合成测试和工程方法在文中分别标识。
附:完整离线对照代码
程序中的人工确认来自输入记录,不能代替对数据定义的核实。精确相等只是本样本的比较结果,数值差异则留给后续调查;两者都不会自动签署上线验收。
#!/usr/bin/env python3
"""Offline daily-OHLC comparison. Python 3.10+, standard library only.

--demo generates clearly labelled synthetic fixtures, never market observations.
No downloads, orders, automatic adjustment, fill-forward, or production cutover.
"""
import argparse
import csv
import hashlib
import html
import json
from collections import defaultdict
from datetime import date, datetime, timezone
from decimal import Decimal, InvalidOperation
from pathlib import Path

FIELDS = ("open", "high", "low", "close")
GATES = ("interval", "currency", "session", "adjustment_basis", "date_basis", "comparability_id")


def csv_write(path, rows, fields):
    with path.open("w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fields)
        writer.writeheader()
        writer.writerows(rows)


def read_rows(path, mapping=None, expected=False):
    groups, issues = defaultdict(list), []
    with path.open(encoding="utf-8-sig", newline="") as f:
        reader = csv.DictReader(f)
        required = {"symbol", "trade_date"} | (set() if expected else set(FIELDS))
        if not required.issubset(reader.fieldnames or []):
            raise ValueError(f"{path.name}: requires {sorted(required)}; flatten multi-level exports first")
        for line, row in enumerate(reader, 2):
            symbol = (row.get("symbol") or "").strip()
            day = (row.get("trade_date") or "").strip()
            try:
                if not symbol or date.fromisoformat(day).isoformat() != day:
                    raise ValueError()
            except ValueError:
                issues.append({"line": line, "reason": "invalid_symbol_or_ISO_date"})
                continue
            symbol = (mapping or {}).get(symbol, symbol)
            if not isinstance(symbol, str) or not symbol.strip():
                issues.append({"line": line, "reason": "invalid_symbol_mapping"})
                continue
            groups[(symbol.strip(), day)].append(row)
    return groups, issues


def prices(row):
    try:
        values = [Decimal(row[k]) for k in FIELDS]
        if any(not n.is_finite() or n <= 0 for n in values):
            return None
        o, h, l, c = values
        return values if h >= max(o, l, c) and l <= min(o, h, c) else None
    except (KeyError, InvalidOperation, TypeError, ValueError):
        return None


def compare(old_path, new_path, old_meta, new_meta, expected_path=None):
    problems = []
    for field in GATES:
        a, b = old_meta.get(field), new_meta.get(field)
        unknown = lambda v: not isinstance(v, str) or v.strip().lower() in ("", "unknown", "unconfirmed")
        if unknown(a) or unknown(b) or a != b:
            problems.append(f"{field}: unknown_or_different")
    if old_meta.get("interval") != "1d" or new_meta.get("interval") != "1d":
        problems.append("interval: this_example_accepts_daily_bars_only")
    if old_meta.get("semantics_reviewed") is not True or new_meta.get("semantics_reviewed") is not True:
        problems.append("semantics_reviewed: human_confirmation_required")
    old, old_issues = read_rows(old_path, old_meta.get("symbol_map"))
    new, new_issues = read_rows(new_path, new_meta.get("symbol_map"))
    expected, expected_issues = read_rows(expected_path, expected=True) if expected_path else ({}, [])
    rows = []
    keys = sorted(set(old) | set(new) | set(expected))
    for key in keys:
        a, b = old.get(key, []), new.get(key, [])
        changes = ""
        if len(a) > 1 or len(b) > 1 or len(expected.get(key, [])) > 1:
            status = "DUPLICATE_KEY"
        elif not a and not b:
            status = "MISSING_BOTH"
        elif not a:
            status = "NEW_ONLY"
        elif not b:
            status = "OLD_ONLY"
        elif problems:
            status = "NOT_COMPARABLE"
        elif prices(a[0]) is None or prices(b[0]) is None:
            status = "INVALID_OHLC"
        else:
            av, bv = prices(a[0]), prices(b[0])
            changes = ";".join(f"{f}:{y-x}" for f, x, y in zip(FIELDS, av, bv) if x != y)
            status = "VALUE_DIFFERENCE" if changes else "EXACT_MATCH"
        rows.append({"symbol": key[0], "trade_date": key[1], "status": status,
                     "old_rows": len(a), "new_rows": len(b), "new_minus_old": changes,
                     "old_close": a[0].get("close", "") if len(a) == 1 else "",
                     "new_close": b[0].get("close", "") if len(b) == 1 else "",
                     "expected_key": key in expected if expected_path else "NOT_CHECKED"})
    counts = {s: sum(r["status"] == s for r in rows) for s in sorted({r["status"] for r in rows})}
    input_errors = {"old": old_issues, "new": new_issues, "expected": expected_issues}
    if any(input_errors.values()) or counts.get("DUPLICATE_KEY"):
        conclusion = "FIX_INPUT_KEYS"
    elif problems:
        conclusion = "ALIGN_METADATA_BEFORE_VALUES"
    elif any(r["status"] != "EXACT_MATCH" for r in rows) or (expected_path and set(old) != set(expected)):
        conclusion = "REVIEW_RECORD_DIFFERENCES"
    elif not rows:
        conclusion = "NO_RECORDS_TO_COMPARE"
    else:
        conclusion = "NO_DIFFERENCES_IN_THIS_SAMPLE"
    return rows, {"comparability_issues": problems, "input_errors": input_errors,
                  "counts": counts, "conclusion": conclusion,
                  "expected_dates_check": "PROVIDED" if expected_path else "NOT_CHECKED",
                  "old_unique_keys": len(old), "new_unique_keys": len(new),
                  "old_source": old_meta.get("source"), "new_source": new_meta.get("source"),
                  "data_kind": "SYNTHETIC_NOT_MARKET_DATA" if any(
                      m.get("data_kind") == "SYNTHETIC_NOT_MARKET_DATA" for m in (old_meta, new_meta)) else "USER_DECLARED_INPUTS",
                  "deployment_signoff": "HUMAN_REVIEW_REQUIRED",
                  "note": "Exact decimal equality is a comparison result, not an accuracy or migration approval."}


def demo_files(folder):
    """All values are invented software-test data for DEMO_A, not a security."""
    base = {"symbol": "DEMO_A", "open": "10", "high": "12", "low": "9", "close": "11"}
    old = [dict(base, trade_date=f"2026-01-{d:02}") for d in (5, 6, 8)]
    new = [dict(base, trade_date=f"2026-01-{d:02}") for d in (5, 7, 8)]
    new[-1]["close"] = "11.05"
    meta = dict(source="SYNTHETIC_DEMO", interval="1d", currency="USD",
                session="regular", adjustment_basis="split_adjusted",
                date_basis="exchange_local_trade_date", semantics_reviewed=True,
                comparability_id="SYNTHETIC_TEST_BASIS_ONLY",
                symbol_map={}, data_kind="SYNTHETIC_NOT_MARKET_DATA")
    for name, data in (("old", old), ("new", new)):
        csv_write(folder / f"{name}.csv", data, ["symbol", "trade_date", *FIELDS])
        (folder / f"{name}.json").write_text(json.dumps(meta, indent=2))
    expected = [{"symbol": "DEMO_A", "trade_date": f"2026-01-{d:02}"} for d in range(5, 10)]
    csv_write(folder / "expected.csv", expected, ["symbol", "trade_date"])


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--demo", action="store_true")
    for name in ("old", "new", "old-meta", "new-meta", "expected"):
        parser.add_argument("--" + name, type=Path)
    parser.add_argument("--out", type=Path, default=Path("comparison_runs"))
    args = parser.parse_args()
    folder = args.out / datetime.now(timezone.utc).strftime("%Y%m%dT%H%M%S%fZ")
    folder.mkdir(parents=True, exist_ok=False)
    if args.demo:
        demo_files(folder)
        args.old, args.new = folder / "old.csv", folder / "new.csv"
        args.old_meta, args.new_meta = folder / "old.json", folder / "new.json"
        args.expected = folder / "expected.csv"
    if not all((args.old, args.new, args.old_meta, args.new_meta)):
        parser.error("Use --demo or supply --old, --new, --old-meta and --new-meta")
    old_meta = json.loads(args.old_meta.read_text(encoding="utf-8"))
    new_meta = json.loads(args.new_meta.read_text(encoding="utf-8"))
    rows, summary = compare(args.old, args.new, old_meta, new_meta, args.expected)
    summary["mode"] = "SYNTHETIC_DEMO" if args.demo else "USER_SUPPLIED_FILES"
    summary["created_at_utc"] = datetime.now(timezone.utc).isoformat()
    summary["inputs"] = {n: str(getattr(args, n)) for n in ("old", "new", "old_meta", "new_meta", "expected")}
    summary["declared_metadata"] = {"old": old_meta, "new": new_meta}
    summary["input_sha256"] = {n: hashlib.sha256(getattr(args, n).read_bytes()).hexdigest()
                               for n in ("old", "new", "old_meta", "new_meta", "expected") if getattr(args, n)}
    csv_write(folder / "row_comparison.csv", rows,
              ["symbol", "trade_date", "status", "old_rows", "new_rows", "old_close", "new_close", "new_minus_old", "expected_key"])
    (folder / "comparison_report.json").write_text(json.dumps(summary, ensure_ascii=False, indent=2), encoding="utf-8")
    columns = ("symbol", "trade_date", "old_close", "new_close", "status", "new_minus_old")
    header = "".join(f"<th>{html.escape(c)}</th>" for c in columns)
    body = "".join("<tr>" + "".join(f"<td>{html.escape(str(r[c]))}</td>" for c in columns) + "</tr>" for r in rows)
    view = ("<!doctype html><html lang='en'><meta charset='utf-8'><meta name='viewport' content='width=device-width'>"
            "<title>Migration comparison</title><style>body{max-width:1000px;margin:40px auto;padding:0 20px;"
            "font:17px system-ui;background:#f8f4eb;color:#123349}table{border-collapse:collapse;width:100%}"
            "th,td{padding:12px;border-bottom:1px solid #ccd3d6;text-align:left}pre{white-space:pre-wrap}"
            ".label{padding:14px;background:#fae2b9;border-radius:8px}</style>"
            "<h1>迁移对齐结果 / Migration comparison</h1><p class='label'>"
            + html.escape(summary["data_kind"]) + " — demonstration or user-supplied input; not a production approval.</p>"
            + "<p>" + html.escape(summary["conclusion"]) + "</p><table><thead><tr>" + header
            + "</tr></thead><tbody>" + body + "</tbody></table><h2>Settings requiring review</h2><pre>"
            + html.escape(json.dumps(summary["comparability_issues"], ensure_ascii=False, indent=2))
            + "</pre><p>HUMAN_REVIEW_REQUIRED. Missing values stay missing. Differences require investigation.</p></html>")
    (folder / "comparison_view.html").write_text(view, encoding="utf-8")
    print(json.dumps({"output": str(folder), "mode": summary["mode"], "counts": summary["counts"],
                      "conclusion": summary["conclusion"], "deployment_signoff": summary["deployment_signoff"]}))


if __name__ == "__main__":
    main()