A股全量行情,你做全市场选股时,可能一直漏了这500只票
TickDB Research ·
A股全量行情,你做全市场选股时,可能一直漏了这500只票
一个让我亏过钱的问题
500只票——这是我在三个不同数据源上,看到的A股数量的最大差值。
中上协口径5535家,Wind口径5496家,CNI指数成分更少。同一个市场,三个权威来源,三个数字。你用的“全市场”,是哪个?
我做全市场选股策略的时候,一直以为自己看的是“全市场”。直到有一次,回测和实盘的差距大到不能用滑点解释。策略逻辑没问题,交易成本假设没问题,回测框架也没问题。最后发现问题出在数据层——我以为的“全市场”,和数据源定义的“全市场”,不是一回事。
具体来说:回测里表现很好的几只票,实盘根本买不进去。查了才知道,那几只票在实盘期间停牌了,但回测用的数据里,它们还在“正常交易”——因为数据源用停牌前的价格填充了停牌期间的K线。回测里它们贡献了收益,实盘里它们只贡献了“买不到”。
这不是“有没有数据”的问题。是“数据怎么定义”的问题。
这篇文章要回答三个问题:
- A股全量行情到底有多少只票?为什么不同数据源给的数量不一样?
- 这些定义问题,怎么影响你的回测和实盘?
- 你怎么验证自己的数据源是不是真的“全”?
这篇文章写给三类人:
| 读者类型 | 你的核心任务 | 这篇文章帮你解决什么 |
|---|---|---|
| 量化投资者 | 跑全市场选股、做因子、做回测 | 为什么回测和实盘对不上,怎么排查数据层的定义问题 |
| 行情应用开发者 | 做看盘、做数据产品、做交易系统 | 怎么判断数据源的“全量”是否真的全,怎么验证 |
| 数据选型决策者 | 为团队选数据源 | 不同数据源的“全量”定义差在哪,怎么对比 |
一、第一个问题:哪些标的算“在”?
1.1 同一个A股,三个数字
“A股全量行情”听起来像一个没有歧义的词。所有A股,所有行情,全量。数一数就知道了。
但如果你真的去数:
| 统计来源 | A股总数 | 北交所 | 来源 |
|---|---|---|---|
| 中上协 2026-06 | 5535 | 323 | 协会月报 |
| Wind 2026Q1 | 5496 | 303 | 数据商 |
| CNI 指数成分 2026-04 | — | 261 | 指数编制 |
同一个市场,三个权威来源,三个数字。
CNI明显少于全市场,因为指数编制会剔除ST、停牌、流动性不足的标的。“指数全量”不等于“上市全量”,“可投资全量”不等于“在册全量”。
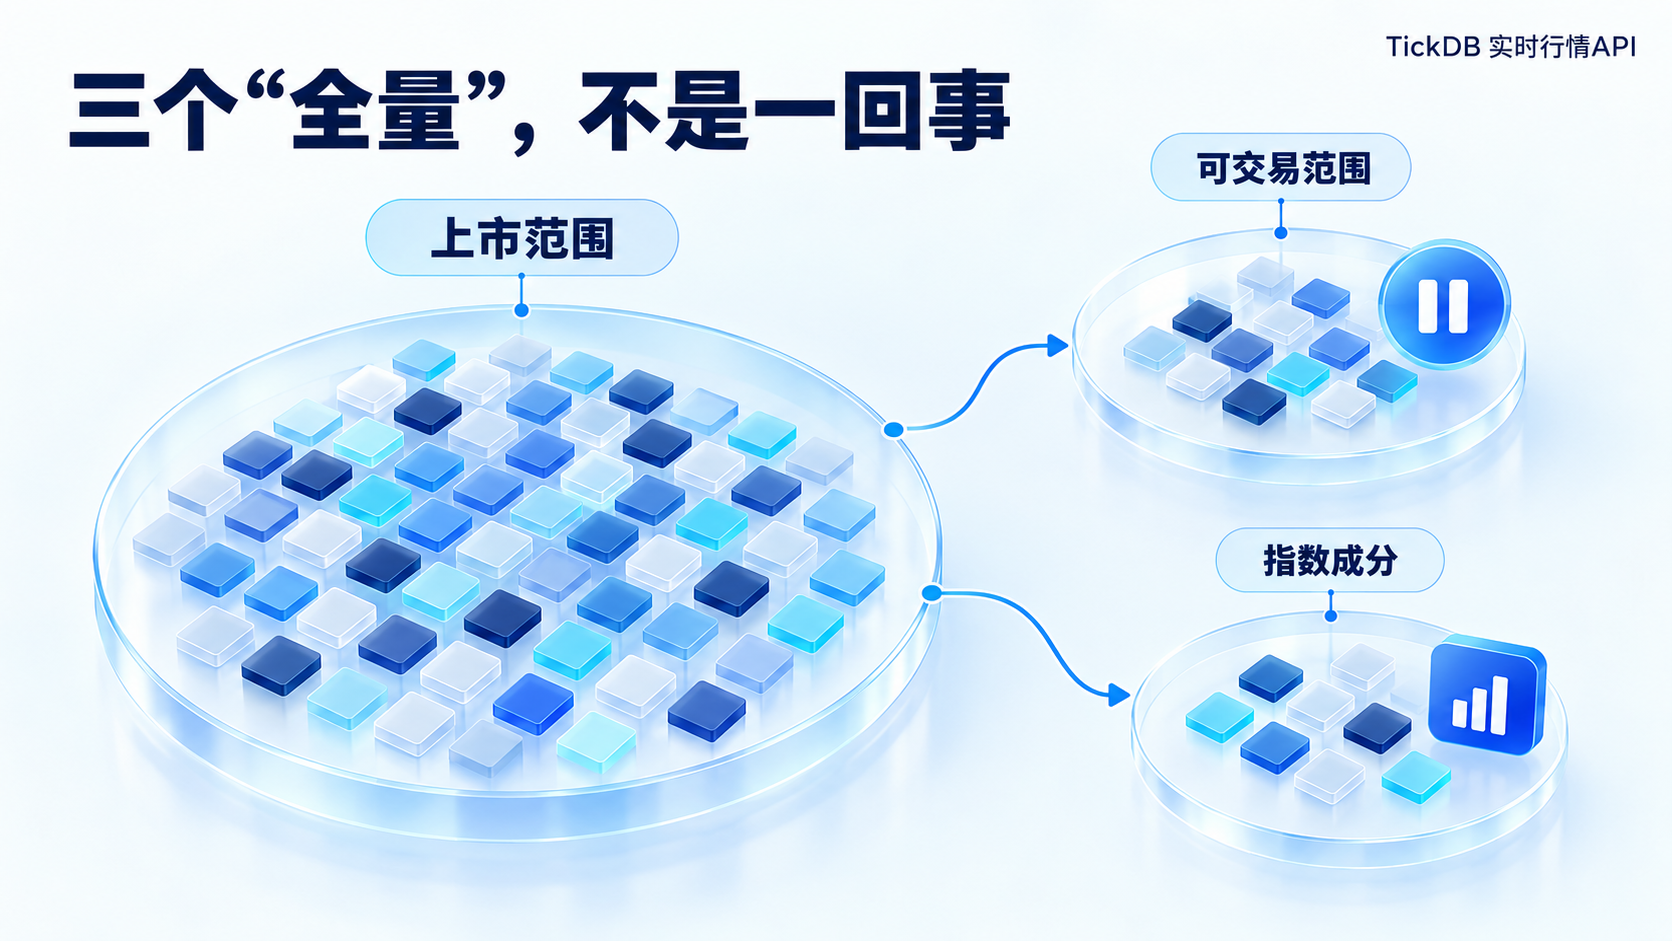
1.2 三个“全量”,三件事
| 维度 | 上市全量 | 可交易全量 | 指数成分全量 |
|---|---|---|---|
| 定义 | 所有在册标的 | 当前可交易的标的 | 指数编制选中的标的 |
| 数量 | 约5500 | 更少(剔除停牌等) | 更少(剔除ST、流动性不足等) |
| 你的用途 | 全市场研究 | 策略选股池 | 指数增强基准 |
“全量”到底指哪个,取决于你要做什么。做全市场研究,上市全量是你的范围;做策略选股,可交易全量才是你的池子;做指数增强,指数成分全量才是你的基准。三者混用,就是定义错位。
1.3 一条行情数据的旅程
要理解“全量”为什么有歧义,需要先理解一条行情数据从产生到被你使用,经过哪些环节:
交易所 ──→ 数据源接入 ──→ 标准化 ──→ 存储 ──→ API ──→ 你的代码
              ↑                                        ↑
        “全量”在这里定义                     你以为的“全量”在这里使用
        (决定覆盖哪些标的)                  (以为覆盖所有上市公司)
核心矛盾:数据源在第一层(接入层)定义了“全量”,但你在第六层(你的代码)使用它。数据源说的“全量”,是它接入的标的范围;你以为的“全量”,是所有上市公司的范围。这两个“全量”,在三个问题上,都可能不是同一个东西。
1.4 你的“全市场”可能只是一个子集
A股有沪市主板、深市主板、创业板、科创板、北交所五个板块。不同板块的上市规则、交易机制、投资者门槛都不同。
一个数据源说“覆盖全市场A股”,它可能覆盖了所有在册标的,但不一定覆盖所有有行情的标的。北交所的标的可能因为在特定时段没有行情返回而“消失”了。
这件事对做策略的人意味着什么?
| 价值类型 | 内容 |
|---|---|
| 投资价值 | 全板块覆盖才能做真正的小市值因子、板块轮动、指数增强。覆盖缺一个板块,你的因子权重就有隐性偏差。 |
| 场景价值 | 做北交所策略的人、做科创板的人、做中证2000增强的人——他们的策略池直接取决于数据源的板块覆盖。 |
| 风险价值 | 样本不全导致选股池隐性缩小,分散化失效。你以为在做全市场均衡配置,实际在做子集集中押注。 |
有学术研究指出,当回测排除按市值排名底部2%的非流动性微盘股时,大量因子的统计显著性会消失。样本覆盖范围——尤其是是否包含微盘、小盘——会极大影响因子有效性的判断。
1.5 停牌股:在册不等于可交易
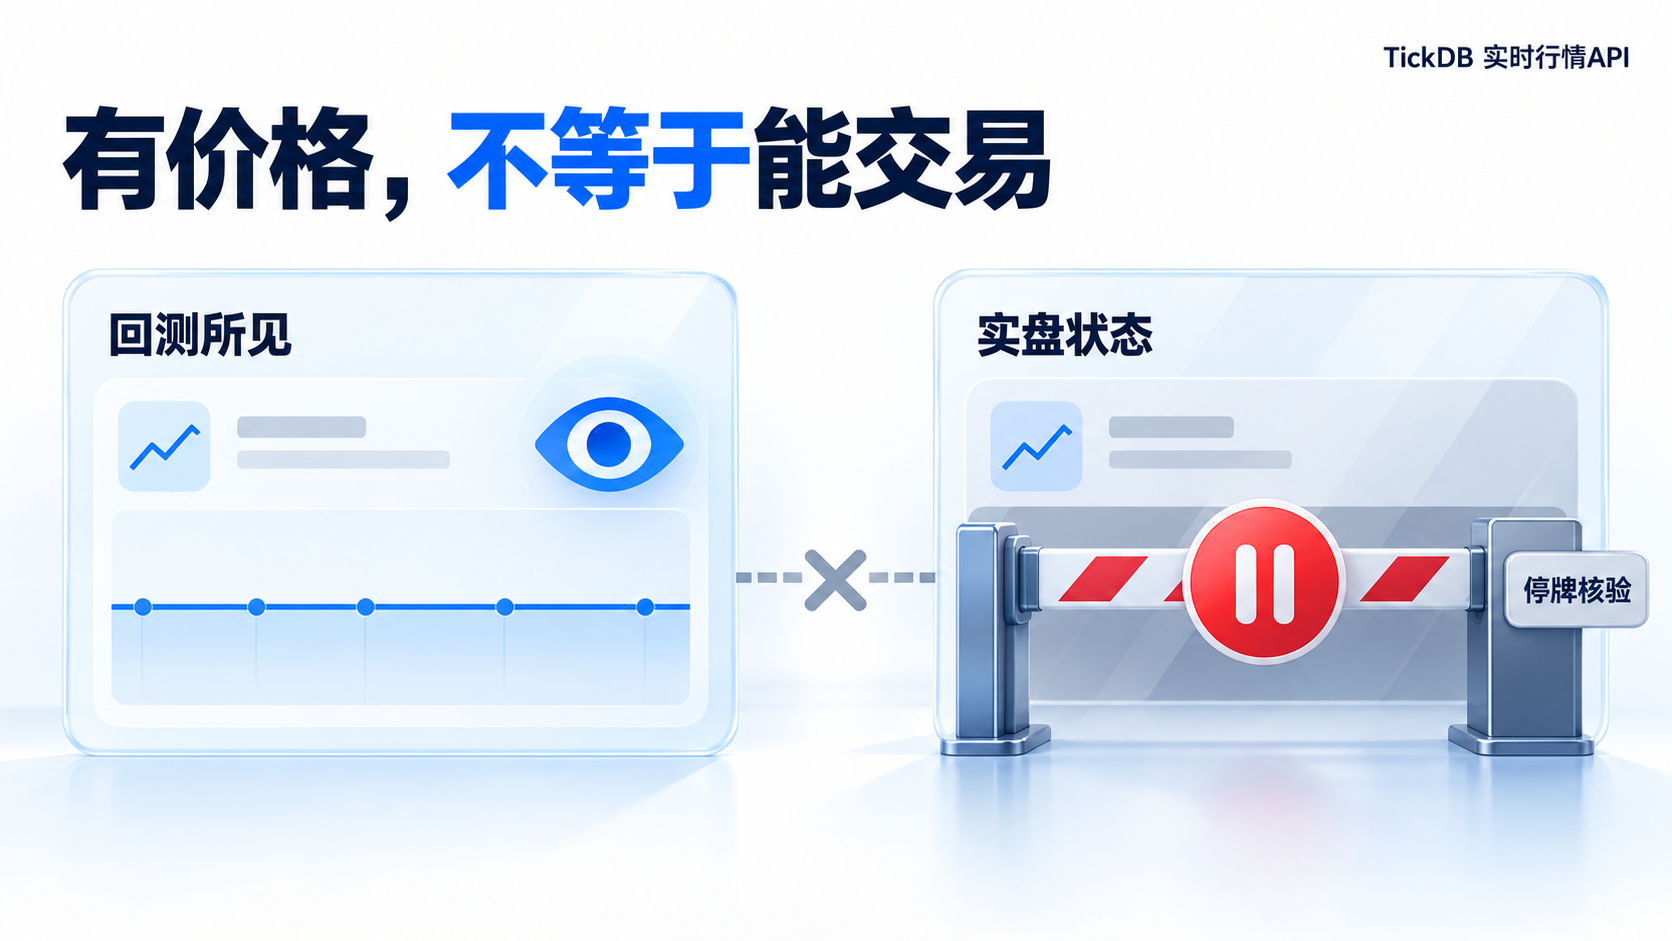
停牌是一个更隐蔽的边界。
| 交易所 | 停牌标志 | 说明 |
|---|---|---|
| 上交所 | SUSP / CLOSE / ENDTR | 当天停牌先后收到SUSP、CLOSE、ENDTR |
| 深交所(版本A) | Y / H / 空格 | Y=长期停牌,H=暂停交易接受委托不撮合 |
| 深交所(版本B) | T / F | T=停牌,F=正常 |
| 北交所/新三板 | F / T / H | F=正常,T=停牌不接受申报,H=停牌接受申报 |
关键问题:交易所告诉你它停牌了,但没有告诉你停牌期间价格字段应该填什么。
这个空白,被数据源和回测框架各自填补:
| 角色 | 可能的处理方式 |
|---|---|
| 数据源 | 前收盘填充 / 空值 / 零 / 上一笔成交价 / 不返回K线 |
| 回测框架 | 跳过停牌日 / 前一日收盘价继续计算净值 / 当交易日处理 |
| 你的代码 | 取决于你怎么处理上面两者的输出 |
你看到的停牌处理,是数据源加回测框架加你的代码共同决定的结果,不是交易所的规定。
这里有一个常见的反推错误:价格没变、成交量为零,不能反推停牌。 价格没变可能是没有新成交,增量通道未推送某只股票也可能只是没有字段变化。停牌判断必须用独立的停复牌信息,不能用行情数据自己反推。
这件事对做策略的人意味着什么?
| 价值类型 | 内容 |
|---|---|
| 投资价值 | 停牌股正确标记,回测才接近实盘。 |
| 场景价值 | 做日频轮动、事件驱动、停牌复牌策略的人。 |
| 风险价值 | 填充价格回测产生未来函数,回测收益虚高,实盘无法复现。回测里的“幽灵收益”,实盘里的“买不到”,很多都来自这里。 |
二、第二个问题:字段怎么填?
2.1 集合竞价:open字段的缺席本身是信息
A股每个交易日的开盘价不是在9:30产生的。9:15到9:25这十分钟,交易所在做统一价格撮合。
09:15 ─── 09:20 ─── 09:25 ─── 09:30
  │          │          │          │
  │  可撤单   │ 不可撤单  │ 统一撮合  │ 连续竞价开始
  │          │          │          │
  │  虚拟参考价实时揭示   │ 开盘价确定 │ 首笔成交
  │          │          │          │
  └──────────┴──────────┘          │
         集合竞价阶段                │
                          开盘价≠首笔成交价
关键事实:9:25确定的开盘价,和9:30连续竞价的第一笔成交价,不是同一个东西。中间有5分钟没有连续交易。
在集合竞价期间,open字段在正式开盘前是缺席的。这个缺席状态本身,是判断“当前是否可以使用开盘价”的最准确信号。
| 数据源 | 集合竞价窗口行为 |
|---|---|
| 有结构化支持的数据源 | 窗口内返回虚拟撮合价;9:25后返回完整竞价结果 |
| 部分免费接口 | 返回空值或报错 |
| 部分数据源 | 分钟线从9:30起记,竞价期间无数据路径 |
这件事对做策略的人意味着什么?
| 价值类型 | 内容 |
|---|---|
| 投资价值 | open字段的缺席状态是判断“当前能否使用开盘价”的最准确信号。 |
| 场景价值 | 开盘交易策略、集合竞价打板策略、9:25后自动下单的系统。 |
| 风险价值 | 把集合竞价的虚拟开盘参考价当真实开盘价,信号提前或错误触发。如果你的数据源不区分9:25和9:30,你的开盘信号可能建立在一个不可成交的价格上。 |
2.2 复权:不是“传个参数就行”
股票在除权除息日会发生价格跳空——不是市场跌了,是股本变了。复权就是把这个“人为跳空”填回去。
| 复权方式 | 计算方向 | 价格基准 | 日频回测是否可用 |
|---|---|---|---|
| 不复权 | 保留原始成交价 | — | 仅用于特定场景 |
| 前复权 | 向后修正历史价格 | 最新价 | 不推荐——历史价格会随新除权事件变动 |
| 后复权 | 向前累积除权因子 | 上市首日价 | 推荐——历史价格钉死 |
前复权在日频回测中是一个未来函数。
不是因为公式错了,是因为数据是动态的。你今天用前复权价格回测,明天某只股票除权了,历史价格变了,你昨天的回测结果就不可复现了。
后复权不存在这个问题。上市首日的价格是锚,后续所有除权事件只往上累积因子,历史价格纹丝不动。但后复权价格通常远大于实际交易价格,用后复权价格做“股价低于5元买入”的判断,触发条件完全错了。
核心不是“前复权好还是后复权好”,是你用它做什么。 信号生成用不复权或后复权,收益计算用后复权,展示给用户看用前复权。三者混用,就是未来函数。
这件事对做策略的人意味着什么?
| 价值类型 | 内容 |
|---|---|
| 投资价值 | 复权逻辑透明,长期收益率计算准确,动量因子、股息率因子不被除权除息干扰。 |
| 场景价值 | 做长周期回测、跨年动量、股息率因子的人。 |
| 风险价值 | 复权方式不一致,跨数据源比较失效,收益率曲线出现假跳空。除权日被误判为“暴跌”,触发错误信号。 |
三、第三个问题:时间是什么时间?
3.1 三个时间,回答三个不同的问题
一条行情数据有三个时间戳,回答三个不同的问题:
| 时间 | 含义 | 回答的问题 |
|---|---|---|
| 源时间 | 数据源标注的时间 | 这条数据是什么时候产生的? |
| 接收时间 | 你收到数据的时间 | 这条数据是什么时候到的? |
| 读取时间 | 你使用数据的时间 | 我现在用的时候,它多大了? |
刚收到的响应,也可能包含旧行情。 你查的是当前时间,但数据源返回的可能是上一个交易日的快照——查询时间和数据时间不是同一天。
如果你用本地接收时间替换源时间,每次重新获取同一份旧数据,都会显得“刚刚更新”。这就是为什么源时间、接收时间、读取时间必须分开保存。
3.2 时间戳可以统一解码,但不代表是同一时刻
行情数据的时间戳字段,通常是一个毫秒精度的整数。不同市场的时间戳可以统一解码到UTC。
但可以统一解码,不代表是同一时刻的行情。
A股收盘 15:00 (UTC+8) ────────┐
                                │  时间轴(UTC)
港股收盘 16:00 (UTC+8) ────────┤
                                │
美股收盘 16:00 (EST/EDT) ──────┘
如果你用本地时间做跨市场对齐,你可能在A股盘中“看到”了当晚才开盘的美股收盘价——回测暴利,实盘爆仓。
更隐蔽的是:不同市场的行情更新频率不在一个量级上。同一时刻发起查询,不同市场返回的数据,实际采集时间可能差了数百毫秒到数秒。回测引擎不会告诉你数据是不同步的——它把两边最新一条数据拼成“当前快照”,不管这两个数据在真实时间轴上差了多久。
3.3 交易日历:按工作日遍历是常见陷阱
A股有午休(11:30-13:00),港股有午休(12:00-13:00),美股无午休。节假日不同,半日市规则不同。
如果你用“按工作日遍历”的方式生成交易日,就会把国庆假期当成交易日——回测里凭空多出七天不存在的交易日。所有依赖连续时间序列的因子,从起点就有偏。
这件事对做策略的人意味着什么?
| 价值类型 | 内容 |
|---|---|
| 投资价值 | 多市场统一时,跨市场套利、全球配置的时间对齐。 |
| 场景价值 | 多市场策略、跨时区监控、A+H联动策略。 |
| 风险价值 | 时间戳不带时区,跨市场对齐会错。交易日历“按工作日”遍历,产生不存在的交易日。 |
四、怎么验证你的“全量”?
4.1 三个具体问题,实测你的数据源
问题一:你的数据源里,北交所有多少只票?
查标的目录,按代码前缀统计。以TickDB为例,A股目录返回7561条,其中92开头348条(北交所标的)。如果你的数据源里这个数字是0,你的“全市场”已经少了300多只。
问题二:停牌股在K线里怎么返回?
找一只已知停牌股,查它停牌期间的K线。以601198.SH为例,该股自2026年9月15日起停牌,查询9月10日至10月1日的日K线,只返回9月10、11、14日三根,停牌区间不返回任何K线。数据源选择“不返回”而非“填充”。
问题三:休市日查询,返回的时间戳是哪天?
10月1日(国庆假期)调用ticker接口,查询600519.SH,返回timestamp为9月30日15:30:28。查询时间和数据时间不是同一天。
这三个问题,你就可以对自己的数据源跑一遍。
4.2 五个验证问题
你不用写完整代码。先回答这五个问题:
| 编号 | 验证问题 | 验证方式 |
|---|---|---|
| 1 | 板块覆盖:各板块有多少只标的? | 查标的目录,按板块分类统计,与交易所官方数量对比 |
| 2 | 停牌处理:停牌期间K线是不返回、填充、还是零? | 找一只已知停牌股,查停牌期间K线 |
| 3 | 集合竞价:open字段在9:15-9:25存在吗? | 在集合竞价时段调用行情接口,检查字段状态 |
| 4 | 复权逻辑:复权是输入参数还是响应字段? | 请求不同复权方式,对比返回结果和字段结构 |
| 5 | 时间戳:查询时间和返回timestamp是同一天吗? | 记录查询时间,解码返回时间戳,对比 |
4.3 一段可运行的验证代码
这段代码可以直接复制运行,验证你的数据源的“全量”是不是真的全:
import requests
from collections import Counter

API_KEY = "your_api_key"
BASE_URL = "https://api.tickdb.ai/v1"
headers = {"X-API-Key": API_KEY}

# 分页获取A股目录全量
all_symbols = []
offset = 0
while True:
    resp = requests.get(
        f"{BASE_URL}/symbols/available",
        params={"market": "CN", "type": "stock", "limit": 1000, "offset": offset},
        headers=headers
    )
    batch = resp.json()["data"]
    if not batch:
        break
    all_symbols.extend(batch)
    offset += 1000

# 按代码前缀统计
prefix_counts = Counter(s["symbol"][:2] for s in all_symbols)
print(f"A股目录总数: {len(all_symbols)}")
print(f"代码前缀分布: {dict(prefix_counts)}")

# 对比:全量ticker快照接口
resp = requests.get(
    f"{BASE_URL}/market/ticker/cn-stock",
    headers={**headers, "Accept-Encoding": "gzip"}
)
ticker_data = resp.json()
print(f"全量ticker快照总数: {len(ticker_data['data'])}")
4.4 TickDB 是什么,在A股全量行情中有什么优势
上面这些验证,我用TickDB的接口跑了一遍。
TickDB为开发者和AI应用提供统一的全球行情数据接口,让团队通过一套接入获取多市场实时与历史数据,更快构建行情、分析和监控产品。
在A股全量行情这个场景中,TickDB有三个可验证的优势:
| 优势 | 具体表现 |
|---|---|
| 多市场统一 | 一套API覆盖A股/港股/美股/期货/外汇,标的目录可查询、可分类 |
| 字段结构确定 | 停牌、集合竞价等边界状态有明确字段行为,不是“看起来有数据” |
| 复权逻辑透明 | 复权因子有独立接口,公式可验证,不依赖数据源黑箱 |
实测发现:TickDB的目录接口返回A股type=stock 7561条,全量ticker快照接口返回8075条,两个统计方式归一后交集7473条。停牌股在K线里不返回,ticker没有停牌标记。复权因子公式是复权价格 = 原始价格 × factor_a + factor_b。
这不是说TickDB有问题。恰恰相反,它的接口对“全量”的定义是清晰的——目录有目录的定义,快照有快照的定义,两者不同,但都明确。
真正的问题是:你的策略用的是哪个定义?
结尾
回到开头的问题。
“A股全量行情”到底是什么?
“全量”不是数量,是定义。你用的“全量”,和数据源定义的“全量”,可能不是同一个东西。
数据源在第一层定义的“全量”,和你在第六层使用的“全量”,在这三个问题上,都可能不是同一个东西。
你现在的数据源,敢不敢让你用这五个问题跑一遍?
不用写完整代码。先查第一个:它的标的目录里,北交所的票,有多少只。
数据接入检查清单
把这张表填完,你的数据架构图就出来了。
| 能力层 | 品类 | 是否需要 | 是否已接入 |
|---|---|---|---|
| 行情 | 实时快照 | ||
| 行情 | K线(含复权) | ||
| 行情 | 复权因子 | ||
| 行情 | 分时 | ||
| 行情 | 盘口深度 | ||
| 行情 | 逐笔成交 | ||
| 行情 | 资金流 | ||
| 参考 | 交易日历 | ||
| 参考 | 交易时段 | ||
| 参考 | 标的信息 | ||
| 参考 | 符号目录 | ||
| 接入 | REST | ||
| 接入 | WebSocket |
FAQ
Q1:A股全量行情到底有多少只股票?
没有唯一答案。中上协2026年6月口径5535家,Wind 2026Q1口径5496家,CNI指数成分2026年4月口径更少(因剔除ST、停牌等)。关键是你要的是“上市全量”“可交易全量”还是“指数成分全量”。
Q2:停牌股在行情数据里怎么处理?
取决于数据源。可能用前收盘填充,可能返回空值,可能返回零,也可能不返回K线。你必须自己验证,不能假设。另外,价格没变、成交量为零不能反推停牌,必须用独立的停复牌信息。
Q3:前复权和后复权哪个更好?
不是“哪个更好”的问题。信号生成用不复权或后复权,收益计算用后复权,展示给用户看用前复权。前复权在日频回测中是一个未来函数,历史价格会随新的除权事件动态变动。
Q4:集合竞价期间open字段是什么?
在正式开盘前(9:25之前),open字段通常是缺席的。这个缺席状态本身,是判断“当前是否可以使用开盘价”的最准确信号。但不同数据源处理方式不同,必须实测。
Q5:TickDB在A股全量行情中有什么优势?
TickDB提供统一的全球行情数据接口,一套接入覆盖A股/港股/美股/期货/外汇。在A股全量场景中,它的优势是:多市场统一、字段结构确定、复权逻辑透明。
Q6:怎么判断我的数据源是不是真的“全”?
先回答五个问题:各板块有多少只标的?停牌期间K线怎么返回?集合竞价open字段存在吗?复权是输入参数还是响应字段?查询时间和返回timestamp是同一天吗?文章第四部分有可运行的验证代码。
参考资料
- 中国上市公司协会统计月报(2026年6月)
- Wind资讯A股统计数据(2026年Q1)
- CNI指数成分数据(2026年4月)
- 上海证券交易所Level-2行情接口规范
- 深圳证券交易所交易数据接口规范(Ver 4.57/4.60/4.72)
- 全国中小企业股份转让系统、北京证券交易所《交易支持平台数据接口规范(V2.2)》(2023年3月)
- Rob Arnott et al. 因子研究(447个因子,排除底部2%微盘股后64%无法提供统计显著alpha)
- TickDB官方文档(docs.tickdb.ai)
- TickDB REST API实测数据(2026年10月1日)
- 腾讯云开发者社区《A股批量行情的完整性与时效校验》(2026年9月30日)