A股、港股、美股一起研究,行情分散会漏掉什么?用实时行情数据源实测3个样本
TickDB Research ·
只研究A股时,行情分开看似乎没什么。把港股和美股加进来后,三套入口很容易让某个市场、某只股票,甚至某一段变化根本没有进入同一轮观察。
行情分散最容易漏掉的,不是一条价格,而是没有进入同一研究流程的市场、样本和时间窗口。 我用TickDB这个实时行情数据源做了次实测:贵州茅台 600519.SH、腾讯控股 700.HK、苹果 AAPL.US,全部放进同一段Python程序,连续读取市场目录、当前行情、5日与10日变化、量比和20根日K线。
8次请求,三个市场,3/3通过。
先看结果
运行时间:2026-07-24T06:12:58+00:00
| 市场 | 样本 | 当次现价 | 5日变化 | 10日变化 | 量比 | 日K线 | 结果 |
|---|---|---|---|---|---|---|---|
| A股 | 600519.SH 贵州茅台 | 1296.52 | 3.19% | 7.30% | 0.44 | 20根 | PASS |
| 港股 | 700.HK 腾讯控股 | 433.8 | -5.98% | -5.69% | 0.64 | 20根 | PASS |
| 美股 | AAPL.US Apple Inc. | 321.66 | -3.48% | 1.72% | 0.78 | 20根 | PASS |
8个请求很简单:三个市场目录、一次批量ticker、一次批量指标,再分别读取三只股票的日K线。
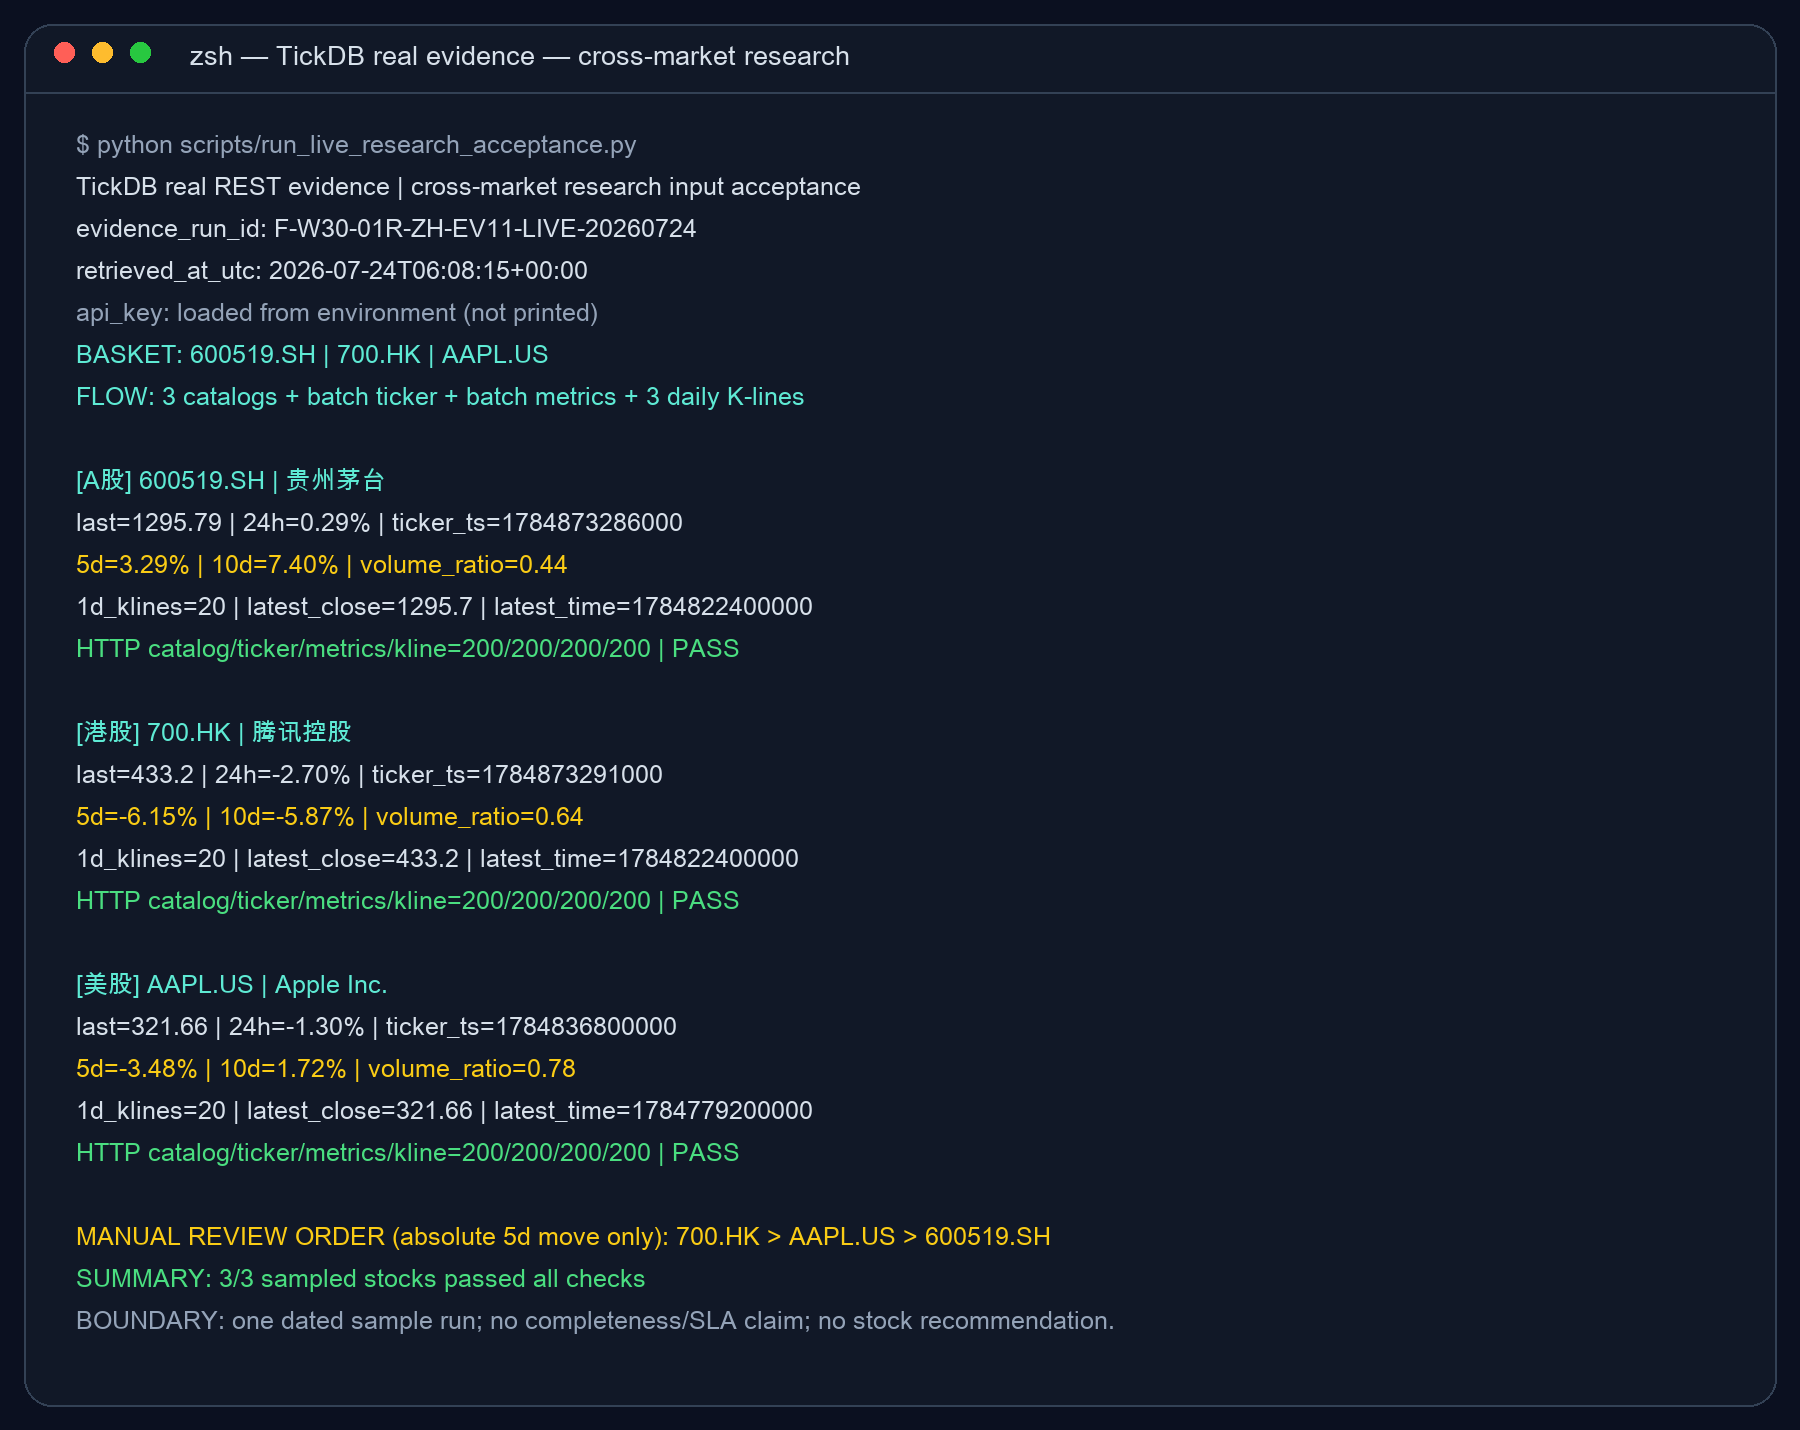 2026年7月24日,三个样本的单次运行记录。
目录、行情、指标和K线共用一个Key、一套请求逻辑和同一份结果检查,这才是这次实测真正想看的东西。
完整代码
把自己的Key放进环境变量,然后运行:
export TICKDB_API_KEY="your-own-key"
python3 public_tickdb_cross_market_check.py
#!/usr/bin/env python3
"""A complete, runnable TickDB cross-market research check.

Before running:
    export TICKDB_API_KEY="your-own-key"

The key is read only from the environment and is never printed or saved.
"""

from __future__ import annotations

import json
import os
import subprocess
import sys
import urllib.parse
from datetime import datetime, timezone
from pathlib import Path
from typing import Any


BASE_URL = "https://api.tickdb.ai"
SAMPLES = [
    ("A股", "CN", "600519.SH"),
    ("港股", "HK", "700.HK"),
    ("美股", "US", "AAPL.US"),
]
OUTPUT_ROOT = Path(__file__).resolve().parents[1]


def get_json(path: str, params: dict[str, Any], api_key: str) -> dict[str, Any]:
    query = urllib.parse.urlencode(params)
    url = f"{BASE_URL}{path}?{query}"
    result = subprocess.run(
        [
            "curl",
            "--location",
            "--silent",
            "--show-error",
            "--max-time",
            "30",
            "--header",
            f"X-API-Key: {api_key}",
            "--header",
            "Accept: application/json",
            "--write-out",
            "\nHTTP_STATUS:%{http_code}",
            url,
        ],
        check=False,
        capture_output=True,
        text=True,
        timeout=35,
    )
    body, marker, status = result.stdout.rpartition("\nHTTP_STATUS:")
    if result.returncode != 0 or not marker or status.strip() != "200":
        raise RuntimeError(
            f"request failed: path={path}, "
            f"curl_exit={result.returncode}, http={status.strip() or 'unknown'}"
        )
    payload = json.loads(body)
    if payload.get("code") != 0:
        raise RuntimeError(
            f"API rejected request: path={path}, code={payload.get('code')}, "
            f"message={payload.get('message')}"
        )
    return payload


def rows_by_symbol(payload: dict[str, Any]) -> dict[str, dict[str, Any]]:
    return {
        row["symbol"]: row
        for row in payload["data"]
        if isinstance(row, dict) and "symbol" in row
    }


def pct(value: Any) -> str:
    return f"{float(value) * 100:.2f}%"


def main() -> int:
    api_key = os.getenv("TICKDB_API_KEY")
    if not api_key:
        print("请先在环境变量中设置 TICKDB_API_KEY", file=sys.stderr)
        return 2

    raw_bundle: dict[str, Any] = {
        "retrieved_at_utc": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "credential": "loaded from environment; value not saved",
        "requests": {},
    }

    catalog_totals: dict[str, int] = {}
    for _, market, _ in SAMPLES:
        payload = get_json(
            "/v1/symbols/available",
            {"market": market, "type": "stock", "limit": 3, "offset": 0},
            api_key,
        )
        raw_bundle["requests"][f"catalog_{market}"] = payload
        catalog_totals[market] = payload["data"]["pagination"]["total"]

    symbols = ",".join(symbol for _, _, symbol in SAMPLES)
    ticker_payload = get_json(
        "/v1/market/ticker",
        {"symbols": symbols, "type": "stock"},
        api_key,
    )
    metrics_payload = get_json(
        "/v1/market/calc-index",
        {"symbols": symbols, "type": "stock"},
        api_key,
    )
    raw_bundle["requests"]["ticker"] = ticker_payload
    raw_bundle["requests"]["metrics"] = metrics_payload
    ticker = rows_by_symbol(ticker_payload)
    metrics = rows_by_symbol(metrics_payload)

    output_lines = [
        f"retrieved_at_utc: {raw_bundle['retrieved_at_utc']}",
        "api_key: loaded from environment (not printed)",
        "basket: 600519.SH | 700.HK | AAPL.US",
        "",
    ]
    review_order: list[tuple[float, str]] = []

    for market_name, catalog_market, symbol in SAMPLES:
        kline_payload = get_json(
            "/v1/market/kline",
            {"symbol": symbol, "type": "stock", "interval": "1d", "limit": 20},
            api_key,
        )
        raw_bundle["requests"][f"kline_{symbol}"] = kline_payload
        bars = kline_payload["data"]["klines"]
        quote = ticker[symbol]
        indicator = metrics[symbol]
        review_order.append((abs(float(indicator["five_day_change_rate"])), symbol))

        output_lines.extend(
            [
                f"[{market_name}] {symbol} {quote['name']}",
                (
                    f"目录股票数={catalog_totals[catalog_market]} | "
                    f"现价={quote['last_price']} | 24h={quote['price_change_percent_24h']}%"
                ),
                (
                    f"5日={pct(indicator['five_day_change_rate'])} | "
                    f"10日={pct(indicator['ten_day_change_rate'])} | "
                    f"量比={indicator['volume_ratio']}"
                ),
                (
                    f"日K线={len(bars)}根 | 最近收盘={bars[-1]['close']} | "
                    f"时间={bars[-1]['time']} | PASS"
                ),
                "",
            ]
        )

    review_order.sort(reverse=True)
    output_lines.extend(
        [
            "人工复核顺序(仅按5日绝对涨跌幅):"
            + " > ".join(symbol for _, symbol in review_order),
            "SUMMARY: 3/3 samples passed",
            "BOUNDARY: 本次三个样本、单次运行;不是荐股、收益排名或SLA证明。",
        ]
    )

    raw_path = OUTPUT_ROOT / "raw" / "public_code_run_bundle.json"
    transcript_path = OUTPUT_ROOT / "terminal" / "public_code_run_terminal.txt"
    raw_path.write_text(
        json.dumps(raw_bundle, ensure_ascii=False, indent=2) + "\n",
        encoding="utf-8",
    )
    transcript = "\n".join(output_lines) + "\n"
    transcript_path.write_text(transcript, encoding="utf-8")
    print(transcript, end="")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
同一次终端输出
retrieved_at_utc: 2026-07-24T06:12:58+00:00
api_key: loaded from environment (not printed)
basket: 600519.SH | 700.HK | AAPL.US

[A股] 600519.SH 贵州茅台
目录股票数=7059 | 现价=1296.52 | 24h=0.35%
5日=3.19% | 10日=7.30% | 量比=0.44
日K线=20根 | 最近收盘=1296.83 | 时间=1784822400000 | PASS

[港股] 700.HK 腾讯控股
目录股票数=3156 | 现价=433.8 | 24h=-2.56%
5日=-5.98% | 10日=-5.69% | 量比=0.64
日K线=20根 | 最近收盘=434 | 时间=1784822400000 | PASS

[美股] AAPL.US Apple Inc.
目录股票数=12587 | 现价=321.66 | 24h=-1.30%
5日=-3.48% | 10日=1.72% | 量比=0.78
日K线=20根 | 最近收盘=321.66 | 时间=1784779200000 | PASS

人工复核顺序(仅按5日绝对涨跌幅):700.HK > AAPL.US > 600519.SH
SUMMARY: 3/3 samples passed
BOUNDARY: 本次三个样本、单次运行;不是荐股、收益排名或SLA证明。
换成自己的股票,再跑一次
修改 SAMPLES 里的三个symbol,换成你平时研究的股票。
目录、行情、指标和K线都能连续返回,这套工具才算真正进入你的研究流程。
FAQ
1. A股、港股、美股的symbol应该怎么写?
本文使用 600519.SH、700.HK 和 AAPL.US。不确定代码时,先查 /v1/symbols/available 返回的symbol,再把它放进ticker、指标和K线请求。
2. 为什么ticker现价和日K线的最近收盘价可能不一样?
ticker读取当前行情快照,历史日K线读取已经结束的周期;核对结果时要同时看symbol、时间戳和K线周期,不能只比两个价格。
3. TickDB还能怎样继续做选股研究?
可以先用 calc-index 批量查看5日、10日变化、量比和估值等市场指标,缩小人工研究范围;再用 capital-flow 查看单只股票的主力、大单、中单和小单流入流出。两类数据都能围绕同一批symbol继续查询。
话题:A股、港股、美股、行情工具、TickDB、Python、量化研究