A股回测为什么总不稳?拿到10年历史K线数据后,先验这5件事
TickDB Research ·
标题:A股回测为什么总不稳?拿到10年历史K线数据后,先验这5件事
摘要:很多人第一次做 A 股回测,最关心的是策略逻辑、参数和收益曲线。但真正让回测结果失真的,往往不是模型,而是那份看起来很完整的历史 K 线数据。10 年历史 K 线能让策略穿越牛熊,也能让因子分析有更长样本,但前提是这份数据的 symbol、时间范围、K 线周期、OHLCV 字段、异常和缺口都能被核对。拿到数据后,先验这五件事,再让它进入回测。
很多人第一次做 A 股回测,最容易兴奋的时刻,不是策略写完,而是拿到一份“10 年历史 K 线数据”。
有了 10 年数据,就能看策略是不是穿越牛熊;有了日线、周线、月线,就能做更长周期的因子分析;有了完整 OHLCV,就能把数据喂给 Python、Excel、AI 工具或自己的回测框架。
但这里有一个很容易被忽略的问题:
10 年数据不等于可信数据。
 10 年历史 K 线不等于可信回测数据,进回测前先验五件事。
如果 symbol 对不上,时间范围不清楚,K 线周期混用,成交量口径前后不一致,或者某些交易日的数据缺口被静默填平,那么样本越长,问题可能越大。短样本的问题你看得见,长样本的问题会被回测曲线包装得很平滑。
回测最危险的地方,不是报错。报错至少提醒你停下来。更危险的是数据看起来都在,曲线也画出来了,但底层某几段行情其实已经错了、缺了、混了。
所以,拿到 A 股 10 年历史 K 线数据后,第一件事不是立刻跑策略,而是先问:这份数据能不能被复查?
一、谁真正需要 A 股 10 年历史 K 线数据?
不是所有人都需要 10 年历史 K 线。
如果你只是偶尔看盘,或者只想知道某只股票最近几个月怎么走,短周期数据就够了。但如果你要把行情数字拿去做回测、复盘、因子分析、AI 辅助研究,10 年数据就不只是“更多数据”,而是研究底座。
| 用户类型 | 为什么需要 10 年数据 | 没有它会怎样 |
|---|---|---|
| A 股回测者 | 策略需要穿越不同风格、不同流动性、不同波动阶段 | 样本太短,把阶段性行情误读成策略能力 |
| 多因子研究者 | 因子有效性需要长周期、多品种的横截面验证 | 短样本里的显著因子,拉长后可能只是噪声 |
| AI 分析与数据训练 | 模型需要足够样本才能学到有统计意义的规律 | AI 在一份可能有问题的数据上认真分析 |
| 长期复盘 | 想看某类行情在历史上出现过几次、某个行业在过去周期中的表现 | 时间轴不够,很多问题连问的资格都没有 |
10 年数据只是让你有资格提出这些问题,不代表答案一定可靠。答案可靠之前,数据先要过关。
二、为什么“数据越长”反而可能越危险?
短数据的缺陷通常很明显。你只有三个月样本,你知道它不够完整,不敢太相信。
长数据的麻烦在于,它会给人一种安全感。10 年、几千个交易日、几十万根 K 线,看起来很厚,很完整,很像一个可以放心回测的基础设施。
但只要其中几个关键口径没对齐,问题就会被藏得更深。
- 你以为自己在查
600519.SH,但某个环节实际入库的是另一个 symbol; - 你以为拿到的是 2016 年以来的完整日线,但某些停牌、节假日、异常返回没有被解释;
- 字段名都叫
volume,但你没有确认它在你的策略里应该如何理解; - 某次查询失败后,系统没有报错,而是用空值、旧值或缓存值填过去。
回测框架不会替你判断这些。它只会读取数据、计算指标、输出曲线。
数据错的时候,回测也会很认真。
所以,10 年历史 K 线进入回测前,至少先过五道验证。
三、先验五件事
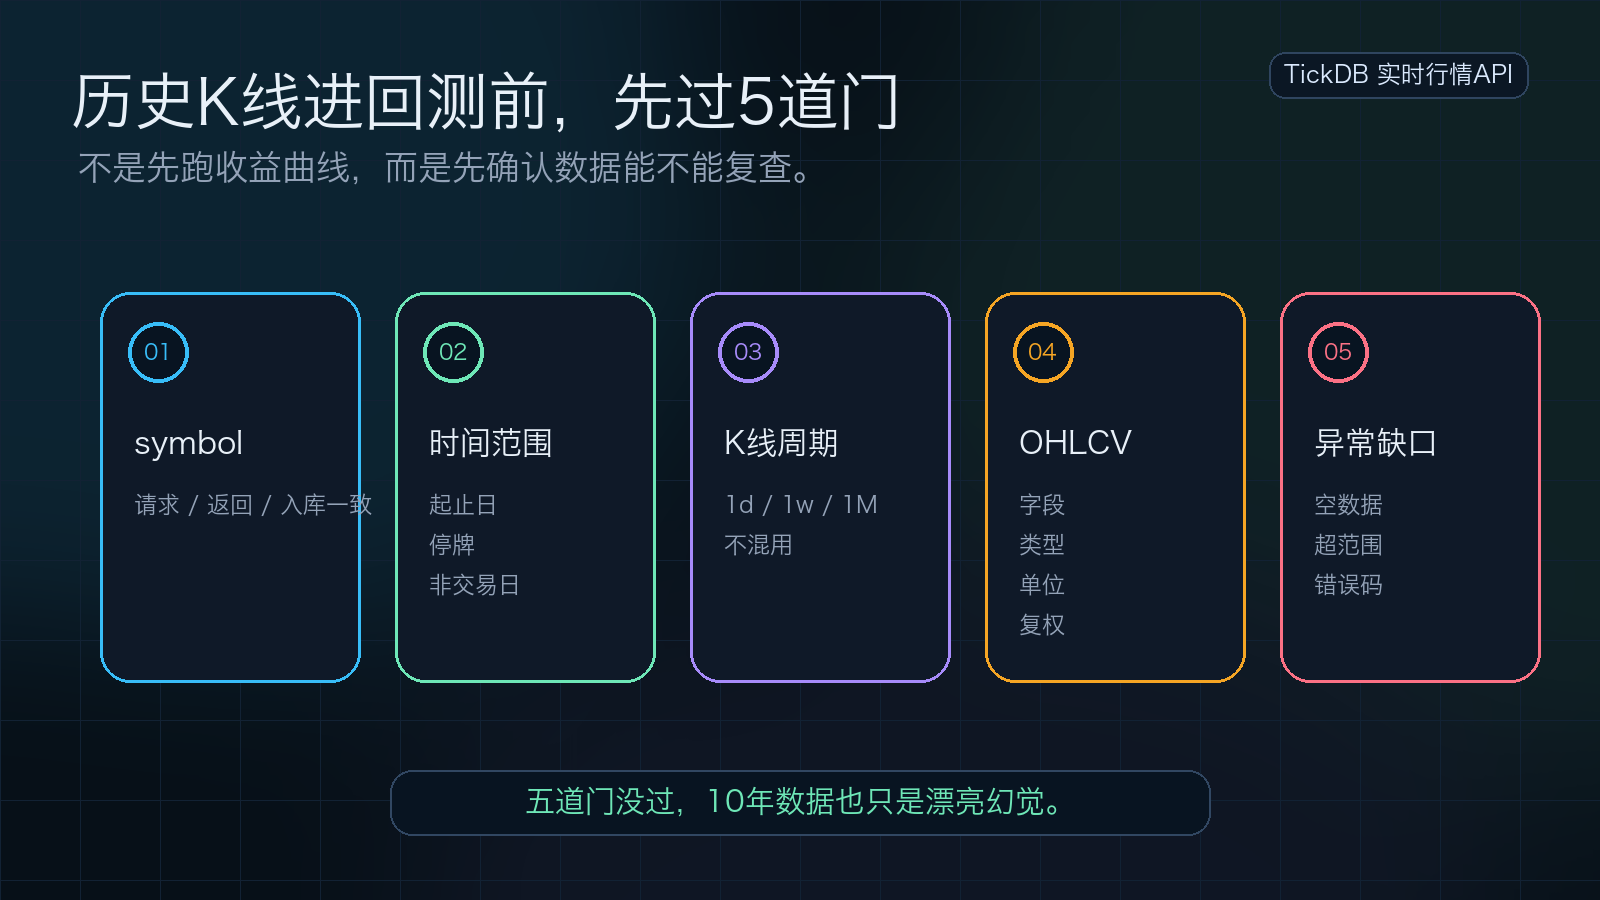 历史 K 线进入回测前,先验 symbol、时间范围、K 线周期、OHLCV 和异常缺口。
| 验证项 | 要确认什么 | 为什么重要 | 怎么验 |
|---|---|---|---|
| symbol | 请求的、返回的、入库的 symbol 是否逐字符一致 | 回测不是聊天,不能靠“应该就是它” | 请求和返回逐字符比对,不放过大小写、后缀、前导零 |
| 时间范围 | 是哪 10 年?从哪天开始,到哪天结束? | 停牌、节假日、非交易日处理直接影响回测样本 | 超范围查询看接口返回;停牌日是否有异常数据 |
| K 线周期 | 日线、周线、月线是否各自独立,支持哪些 interval | 不同周期不是同一把尺,策略周期和接口周期必须一致 | 确认 interval 列表,抽查返回的 K 线时间间隔 |
| OHLCV 字段 | open、high、low、close、volume 含义、类型、单位是否稳定 | 字段名熟悉,但复权口径、单位、类型都可能前后不一致 | 抽查不同年份同名字段的取值范围和变化规律 |
| 异常和缺口 | symbol 不存在、超范围、空数据、权限不足是否有明确返回 | 回测系统最怕静默污染——失败了不说,用缓存填平 | 主动触发异常场景,看返回是报错还是填默认值 |
回测之前先验这五件事。验不过的数据,样本再长也是垃圾进、垃圾出。
四、我用 TickDB 做了一个最小验证
为了避免停留在概念,我用 TickDB 的 REST API 做了一次最小验证。
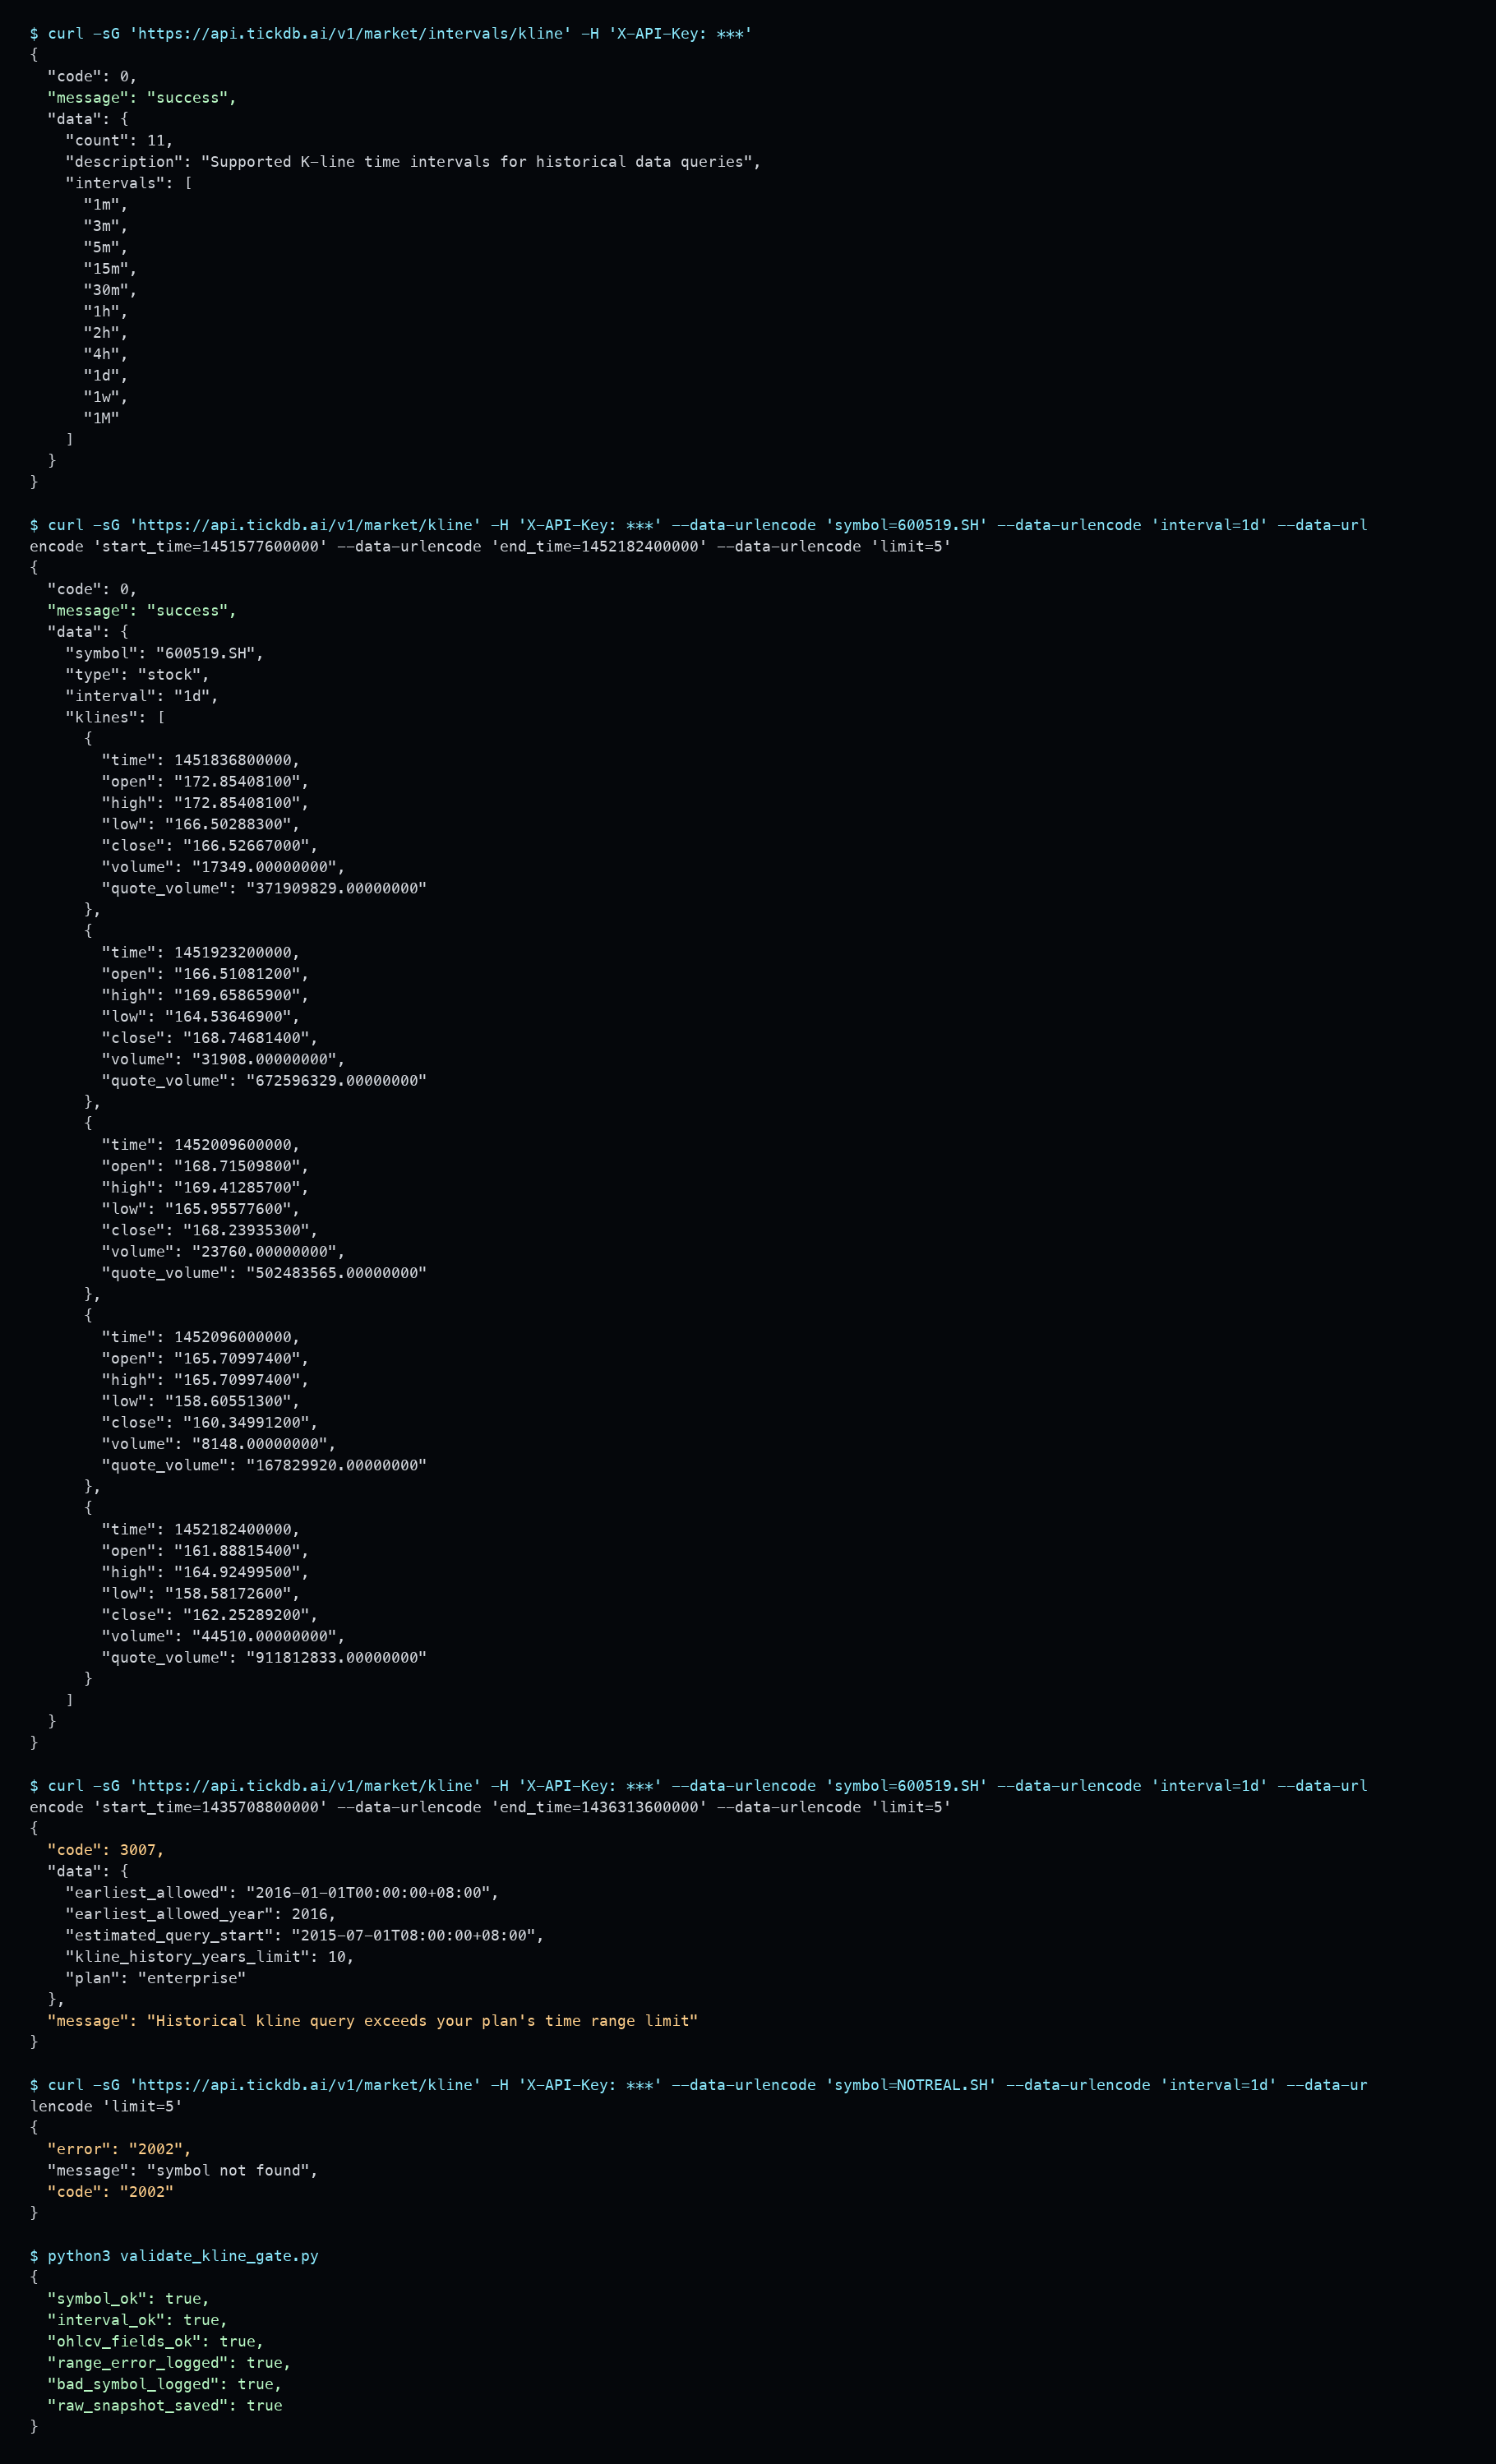 实测 TickDB REST API:K 线周期返回成功,600519.SH 日 K 返回 OHLCV 字段。
这次验证只看三件事:
- K 线周期接口能不能返回可用 interval
- A 股历史 K 线能不能查到 2016 年附近的日 K 样本
- 超出历史范围、错误 symbol 这类异常是否有明确返回
实测结果如下:
| 验证场景 | 请求内容 | 返回结果 |
|---|---|---|
| K 线周期查询 | 查询可用 interval | 返回 1m、3m、5m、15m、30m、1h、2h、4h、1d、1w、1M |
| 历史日 K 查询 | 600519.SH 2016 年 1 月附近 | 返回结构化 time、open、high、low、close、volume |
| 超范围查询 | 2015 年 7 月附近数据 | 返回结构化错误,提示 earliest_allowed 和 kline_history_years_limit |
| 无效 symbol | NOTREAL.SH | 返回 symbol not found |
这几个结果不能证明“所有 A 股、所有周期、所有历史边界都已经完整验证”,但能证明一件对回测很重要的事:
这类历史 K 线查询,可以被程序化验证,而不是只靠人工看一眼价格。
五、TickDB 在这件事里的价值是什么?
TickDB 不是选股工具,也不替你判断策略能不能赚钱。
它更适合解决一个更前置的问题:把行情数据接进你的研究脚本、AI 工具、行情面板或团队系统之前,先给你一个可查询、可核对、可留痕的数据入口。
TickDB 是一个统一实时行情数据 API,支持 REST、WebSocket、MCP、Skill、CLI 等接入方式:
| 接入方式 | 适合场景 |
|---|---|
| REST | 用 Python、脚本或后端服务拉历史 K 线 |
| WebSocket | 做实时行情面板、监控和推送 |
| MCP | 让 Cursor、Claude Code 等 AI 工具直接查询行情 |
| Skill / CLI | 轻量自动化或 AI 工作流 |
在本文讨论的 A 股历史 K 线场景里,最核心的是 REST 历史 K 线接口。你可以用它按 symbol 和 interval 查询历史 K 线,拿到结构化返回,再把 symbol、time、open、high、low、close、volume、错误码和 message 纳入自己的验收流程。
它的价值不是“替你完成回测”,而是让你在回测之前先把数据检查做扎实。
更直接一点说:
- 如果你只是看一眼行情,普通行情软件就够了。
- 如果你要把数据放进脚本、数据库、AI 工具或团队流程里,就需要一套能被程序复查的数据入口。TickDB 适合做这个入口。
六、不要把历史 K 线数据神化
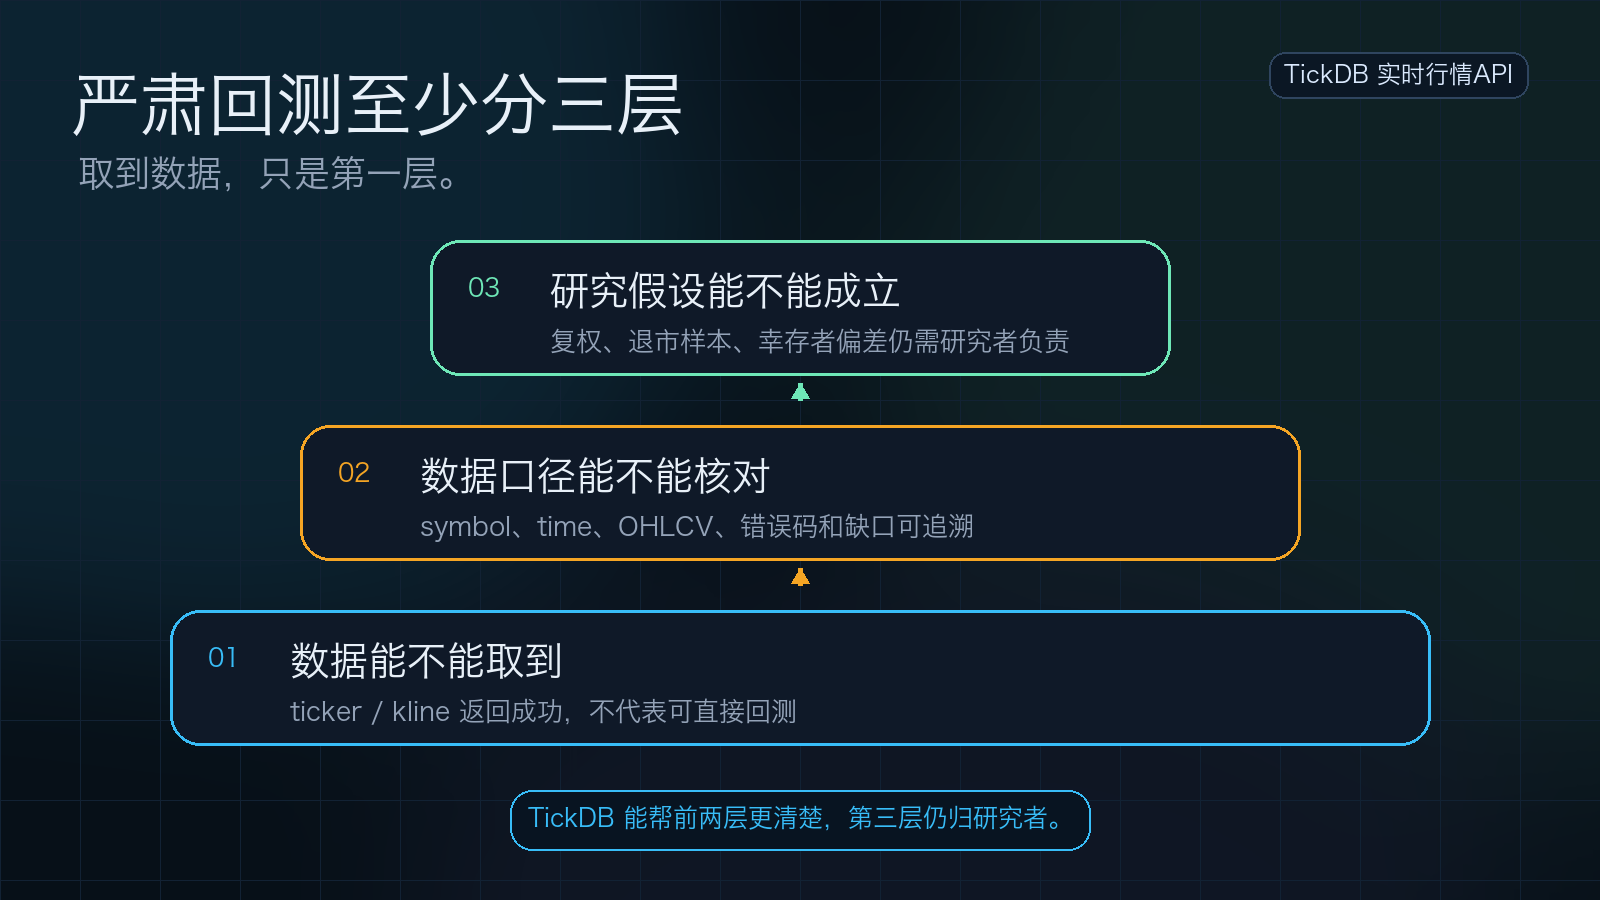 取到数据只是第一层,能核对口径是第二层,研究假设是否成立仍然要由研究者负责。
即使拿到了 10 年历史 K 线,也不要把它神化。
10 年数据不能自动解决策略有效性问题。不能自动解决复权口径问题。不能自动解决退市样本问题。不能自动解决幸存者偏差问题。也不能替你判断买卖。
真正严肃的 A 股回测,至少要分三层:
| 层次 | 要解决的问题 | 谁的责任 |
|---|---|---|
| 第一层 | 数据能不能取到 | 数据源提供可查询、可核对的结构化入口 |
| 第二层 | 数据口径能不能核对 | 研究者逐项核对 symbol、时间、周期、字段、异常 |
| 第三层 | 研究假设能不能成立 | 研究者自己的策略逻辑、样本池和回测框架 |
TickDB 能帮你把前两层做得更清楚。但第三层仍然是研究者自己的责任。
七、最后给你一张最小检查表
下次拿到一份 A 股 10 年历史 K 线数据,不管来自哪里,都可以先填这张表。
| 检查项 | 结果 | 备注 |
|---|---|---|
| symbol 格式是否统一 | ☐ | 是否带市场后缀,有没有被自动修正 |
| 时间范围是否明确 | ☐ | 起止日期、交易日历、停牌处理 |
| K 线周期是否清楚 | ☐ | interval 定义、策略周期是否匹配 |
| OHLCV 字段是否稳定 | ☐ | 抽查不同年份字段含义和类型 |
| 异常和缺口是否有记录 | ☐ | 超范围、错误 symbol、空数据是否返回明确错误 |
如果这张表填不出来,不要急着跑回测。
如果能填出来,你至少知道:这份数据从哪来,覆盖到哪,字段是什么,异常怎么查,出了问题能不能复盘。
回测从来不是先问“策略能不能赚钱”。更底层的问题是:你喂进去的数据,配不配得上这个策略。
最后想问你一个问题:
你做 A 股回测时,最先检查的是策略逻辑,还是历史 K 线数据本身?
你踩过最多的坑,是复权、缺口、symbol,还是字段口径?
本文只讨论 A 股历史 K 线数据的取数、验证和回测前检查方法,不构成任何投资建议。