Codex 给了股票价格,别光看数字:我用 TickDB REST 跑了一张证据卡
TickDB Research ·
Codex 给了股票价格,别光看数字:我用 TickDB REST 跑了一张证据卡
摘要:当 Codex 回答 AAPL.US 的价格时,最危险的回答不是“不知道”,而是一个很完整、很流畅、看起来很像真的数字。行情数据是动态事实,今天的价格和昨天的不是同一个事实,盘前和盘后的价格也不是同一个时间语义。本文不讨论 Codex 能不能预测股价,只讨论一件事:怎么判断它给出的价格是真实通过工具查回来的,还是只是生成了一个“看起来合理的数字”。我用 TickDB REST ticker 在 Codex 工作台里跑了一次真实取数,把请求、返回、时间戳、原始快照和失败分支压进一张可复查的证据卡。
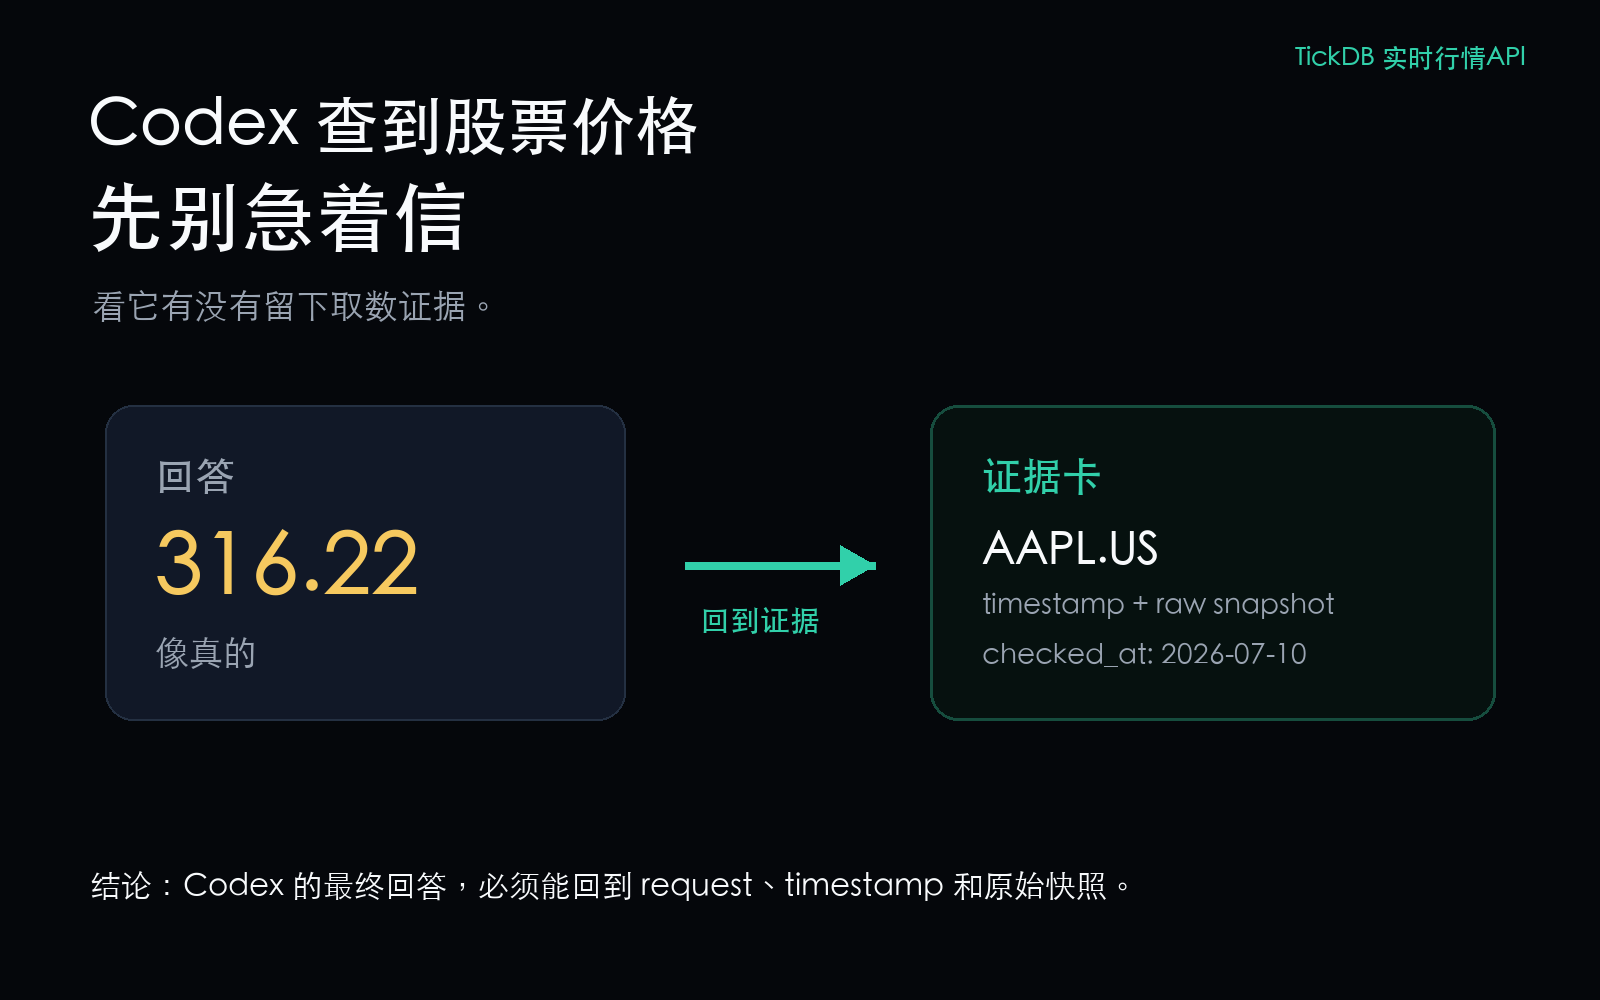
这篇文章在讨论什么
当 Codex、Cursor、Claude Code 这类 AI 编程工具给出一个股票价格时,大多数人的第一反应是看这个数字对不对。
但真正该问的问题在前面一层:
它说这个数字之前,真的查过数据吗?
这件事很容易被忽略。因为这类工具太擅长把话说顺了:代码能写,逻辑能解释,一个价格数字夹在自然语言里,看起来就像真的一样。
但行情数据不是静态知识。
价格会变,时间戳有语义,symbol 有市场后缀,接口返回 HTTP 200 也不等于业务数据真的回来了。
所以我现在看 AI 给出的行情回答,不先看它说得像不像,而是先看它有没有留下证据。
我把这条证据链压成一张卡:
| 要检查什么 | 为什么重要 |
|---|---|
| 请求了什么接口 | 避免模型凭空生成 |
请求的 symbol 是什么 | 避免查错标的 |
返回的 symbol 是否一致 | 避免市场后缀混淆 |
last_price 是否存在 | 避免没有价格却硬答 |
timestamp 是什么 | 避免把旧数据说成当前价格 |
checked_at 是什么时候 | 区分检查时间和行情时间 |
| 原始快照有没有保存 | 出问题后能回放 |
| 失败分支怎么处理 | 没数据时必须停止回答 |
一句话:
回答不是证据,取数链路才是证据。
一、Codex 回答行情时,最危险的不是“不知道”
Codex 回答行情问题时,最危险的状态,不是它明确说“我没有实时数据”。
最危险的是它给出一个很完整、很自然、很像真的答案。
比如你问:
AAPL.US 现在多少钱?
如果它直接给出一个价格,这个数字可能来自真实工具调用,也可能来自旧上下文、缓存、历史样本,甚至只是语言模型根据常见模式补出来的结果。
对普通知识问答来说,回答是否合理有时还能做粗略判断。但对行情数据来说,这不够。
行情数据至少有三个天然麻烦。
第一,价格会变。
今天的价格、昨天的价格、盘前价格、盘后价格,不是同一个事实。
第二,时间很关键。
同样是 316.22,如果没有 timestamp,你不知道它属于哪个市场时刻。
第三,symbol 容易混。
AAPL、AAPL.US、不同市场后缀、不同数据源命名规则,都会影响最终取数。
所以问题不是“Codex 能不能说出价格”,而是:
它说这个价格之前,有没有真正走过一次可复查的取数流程?
二、我在 Codex 里用 TickDB 跑了一次真实取数
这次我在 Codex 工作台里执行 Python 脚本,用 TickDB REST ticker 查询 AAPL.US,并把终端输出、原始返回和证据卡都保存下来。
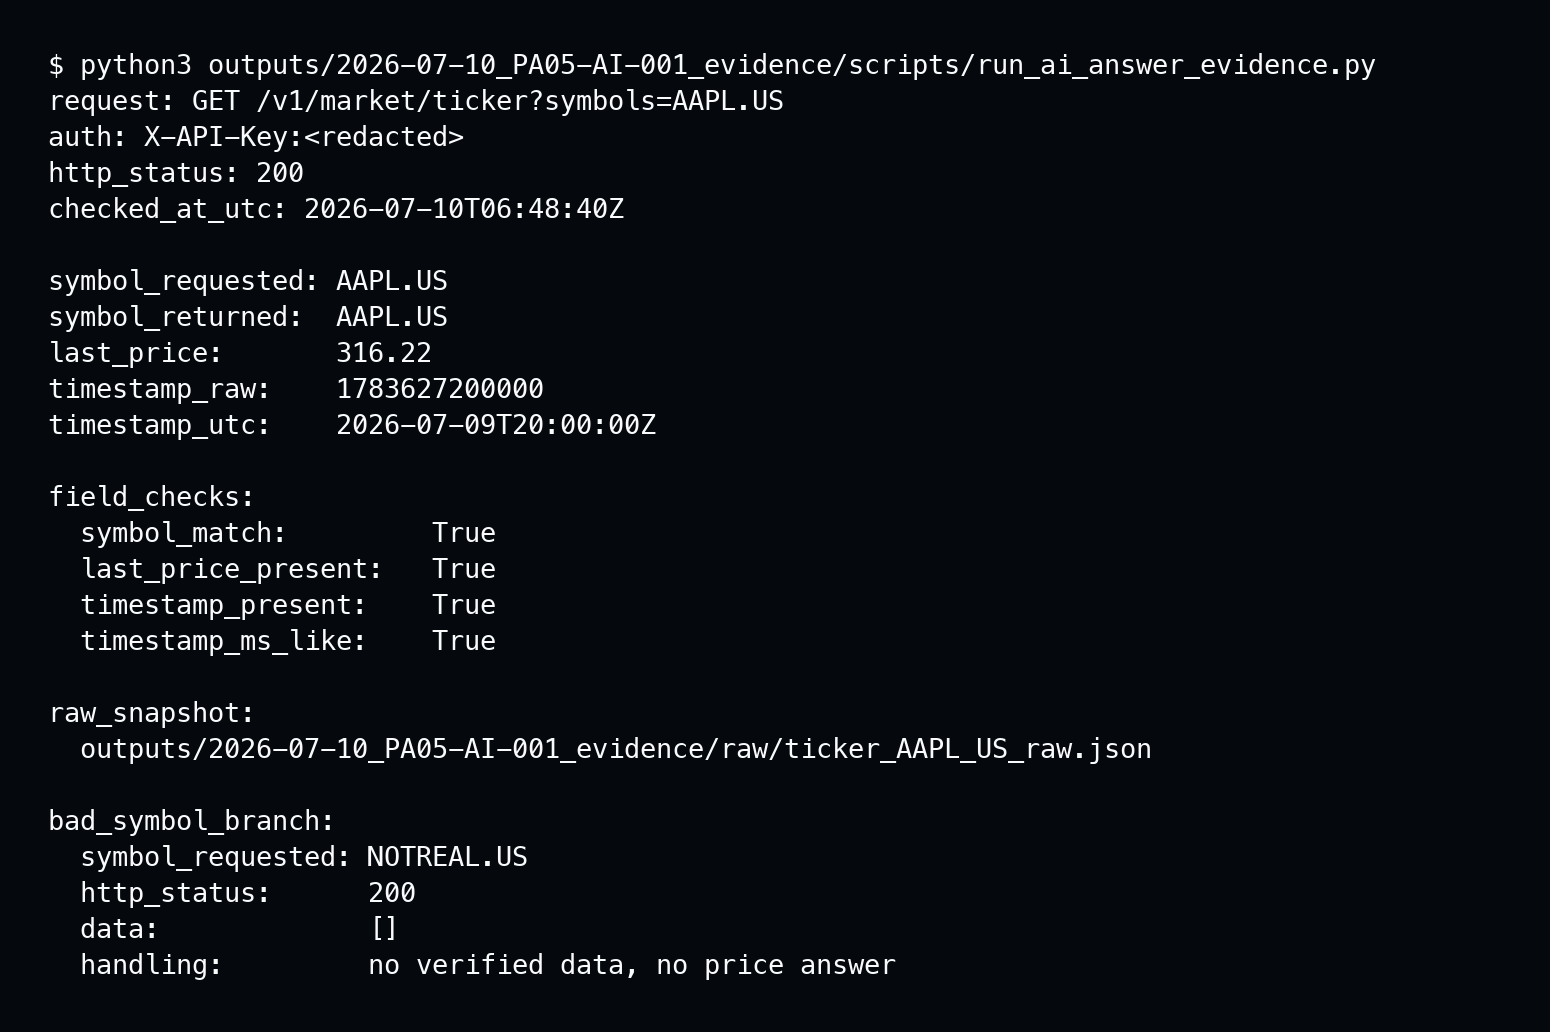
图注:这是本次 Codex 工作台中的终端输出记录。API Key 已脱敏,解释统一写在图注和正文里。
这次实测里,关键字段如下:
| 检查项 | 本次样本 |
|---|---|
| 请求对象 | AAPL.US |
| 返回对象 | AAPL.US |
last_price | 316.22 |
| 行情时间戳 | 1783627200000 |
| 行情时间 UTC | 2026-07-09T20:00:00Z |
| 本次检查时间 UTC | 2026-07-10T06:48:40Z |
| HTTP 状态 | 200 |
| 字段校验 | symbol / price / timestamp 均通过 |
这里有一个非常重要的区别:
行情时间不是检查时间。
timestamp_utc 表示这条行情数据自己携带的时间。
checked_at_utc 表示我这次在 Codex 里运行脚本检查它的时间。
如果把这两个时间混在一起,Codex 的回答就会变得很危险。它明明只是“在某个检查时间拿到了一条带有自身 timestamp 的行情数据”,却被包装成“此刻价格就是这个数”。
更稳妥的表达应该是:
本次在
2026-07-10T06:48:40Z检查时,TickDB REST ticker 返回AAPL.US的last_price为316.22,返回数据中的行情时间为2026-07-09T20:00:00Z。
这句话不夸张,但可复查。
三、Codex 回答前,先过 4 个证据门
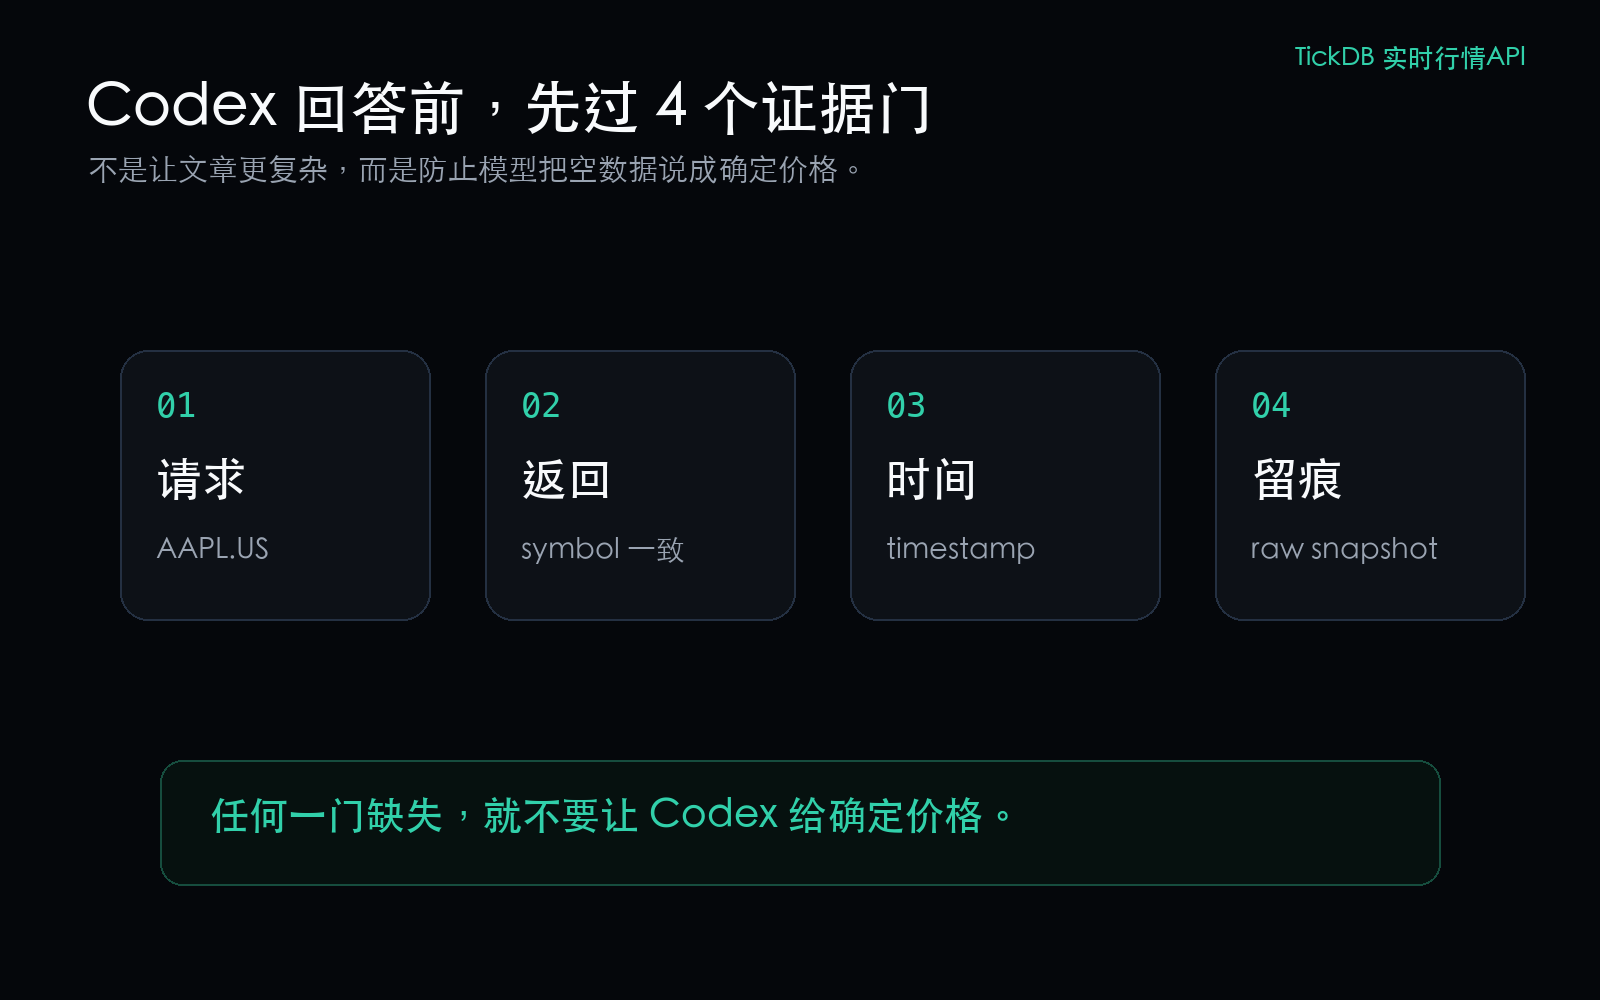
图注:Codex 给确定价格之前,至少要有请求、返回、时间和留痕。
我建议把 Codex 的行情回答拆成两层。
第一层是最终回答,给人看。
第二层是证据卡,给系统和复盘看。
证据卡不是为了把文章写复杂,而是为了防止模型把“空数据、旧数据、错 symbol、无 timestamp”说成确定价格。
一张合格的证据卡,至少要回答这些问题:
| 字段 | 作用 |
|---|---|
question | 用户原始问题是什么 |
tool_or_api | 这次通过什么工具或 API 取数 |
request | 请求方法、接口和参数是什么 |
symbol_requested | 实际请求了哪个标的 |
symbol_returned | 返回标的是否一致 |
last_price | 最终回答引用的价格字段 |
timestamp | 行情数据自身的时间语义 |
checked_at | 这次检查发生在什么时候 |
raw_snapshot_path | 原始返回快照保存在哪里 |
final_answer_rule | 哪些字段缺失时不得回答确定价格 |
这张卡的价值不在于漂亮,而在于能追问。
如果 symbol_requested 和 symbol_returned 不一致,就不能回答价格。
如果 last_price 不存在,就不能回答价格。
如果 timestamp 缺失,就不能把它说成明确时点的行情。
如果没有 raw_snapshot,出问题后就只能相信 Codex 当时那句自然语言回答。
四、HTTP 200 不等于 Codex 真的拿到了价格
这次我还跑了一个失败分支:NOTREAL.US。
结果很有代表性:
接口返回 HTTP 200,但业务数据里的 data 是空数组。
这就是很多 AI 工具接行情接口时容易踩的坑:只看 HTTP 层成功,没看业务数据是否真的存在。
如果 Codex 只看到 HTTP 200,就继续组织回答,它可能会把一次“请求成功但没有可用行情”的结果,包装成一个看起来很确定的价格答案。
所以证据卡里必须有一条硬规则:
没有可核验
data,就不生成价格答案,只记录失败分支。
一个可靠的 Codex 行情工作流,不是永远能回答价格,而是在没有数据时敢于停止回答。
五、这段脚本的核心逻辑
下面是这次在 Codex 工作台里使用的核心逻辑。
它不是伪代码。调用、字段处理、原始快照保存和失败分支都按 TickDB REST ticker 的真实流程写。
使用前需要在本地环境变量中配置 TICKDB_API_KEY。文章里不展示真实 Key。
import json
import os
import hashlib
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlencode
from urllib.request import Request, urlopen

API_KEY = os.environ["TICKDB_API_KEY"]
SYMBOL = "AAPL.US"
RAW_DIR = Path("tickdb_codex_evidence/raw")
RAW_DIR.mkdir(parents=True, exist_ok=True)

url = "https://api.tickdb.ai/v1/market/ticker?" + urlencode({
    "symbols": SYMBOL,
})

request = Request(
    url,
    headers={
        "X-API-Key": API_KEY,
        "Accept": "application/json",
    },
)

checked_at_utc = datetime.now(timezone.utc).strftime("%Y-%m-%dT%H:%M:%SZ")

with urlopen(request, timeout=20) as response:
    http_status = response.status
    payload = json.loads(response.read().decode("utf-8"))

raw_text = json.dumps(payload, ensure_ascii=False, indent=2)
raw_path = RAW_DIR / f"ticker_{SYMBOL.replace('.', '_')}_raw.json"
raw_path.write_text(raw_text, encoding="utf-8")
raw_sha256 = hashlib.sha256(raw_text.encode("utf-8")).hexdigest()

data = payload.get("data") or []
item = data[0] if data else None

if not item:
    evidence = {
        "symbol_requested": SYMBOL,
        "http_status": http_status,
        "checked_at_utc": checked_at_utc,
        "raw_snapshot_path": str(raw_path),
        "raw_snapshot_sha256": raw_sha256,
        "answer_rule": "data 为空,不生成价格答案",
    }
else:
    evidence = {
        "symbol_requested": SYMBOL,
        "symbol_returned": item.get("symbol"),
        "last_price": item.get("last_price"),
        "timestamp_raw": item.get("timestamp"),
        "checked_at_utc": checked_at_utc,
        "raw_snapshot_path": str(raw_path),
        "raw_snapshot_sha256": raw_sha256,
        "field_checks": {
            "symbol_match": item.get("symbol") == SYMBOL,
            "last_price_present": item.get("last_price") is not None,
            "timestamp_present": item.get("timestamp") is not None,
        },
        "answer_rule": "最终回答只能引用 evidence 中已校验字段",
    }

print(json.dumps(evidence, ensure_ascii=False, indent=2))
这段代码真正重要的,不是“能调通接口”。
真正重要的是它把 Codex 的回答拆成了几个硬动作:
- 先请求真实接口
- 保存原始返回
- 检查
symbol - 检查
last_price - 检查
timestamp - 记录
checked_at - 对空数据分支停止回答
- 最终回答只能引用 evidence 中已校验字段
也就是说,Codex 不是直接“说一个价格”。
它必须先拿到证据,再组织语言。
六、把 Codex 的语言和数据证据分开
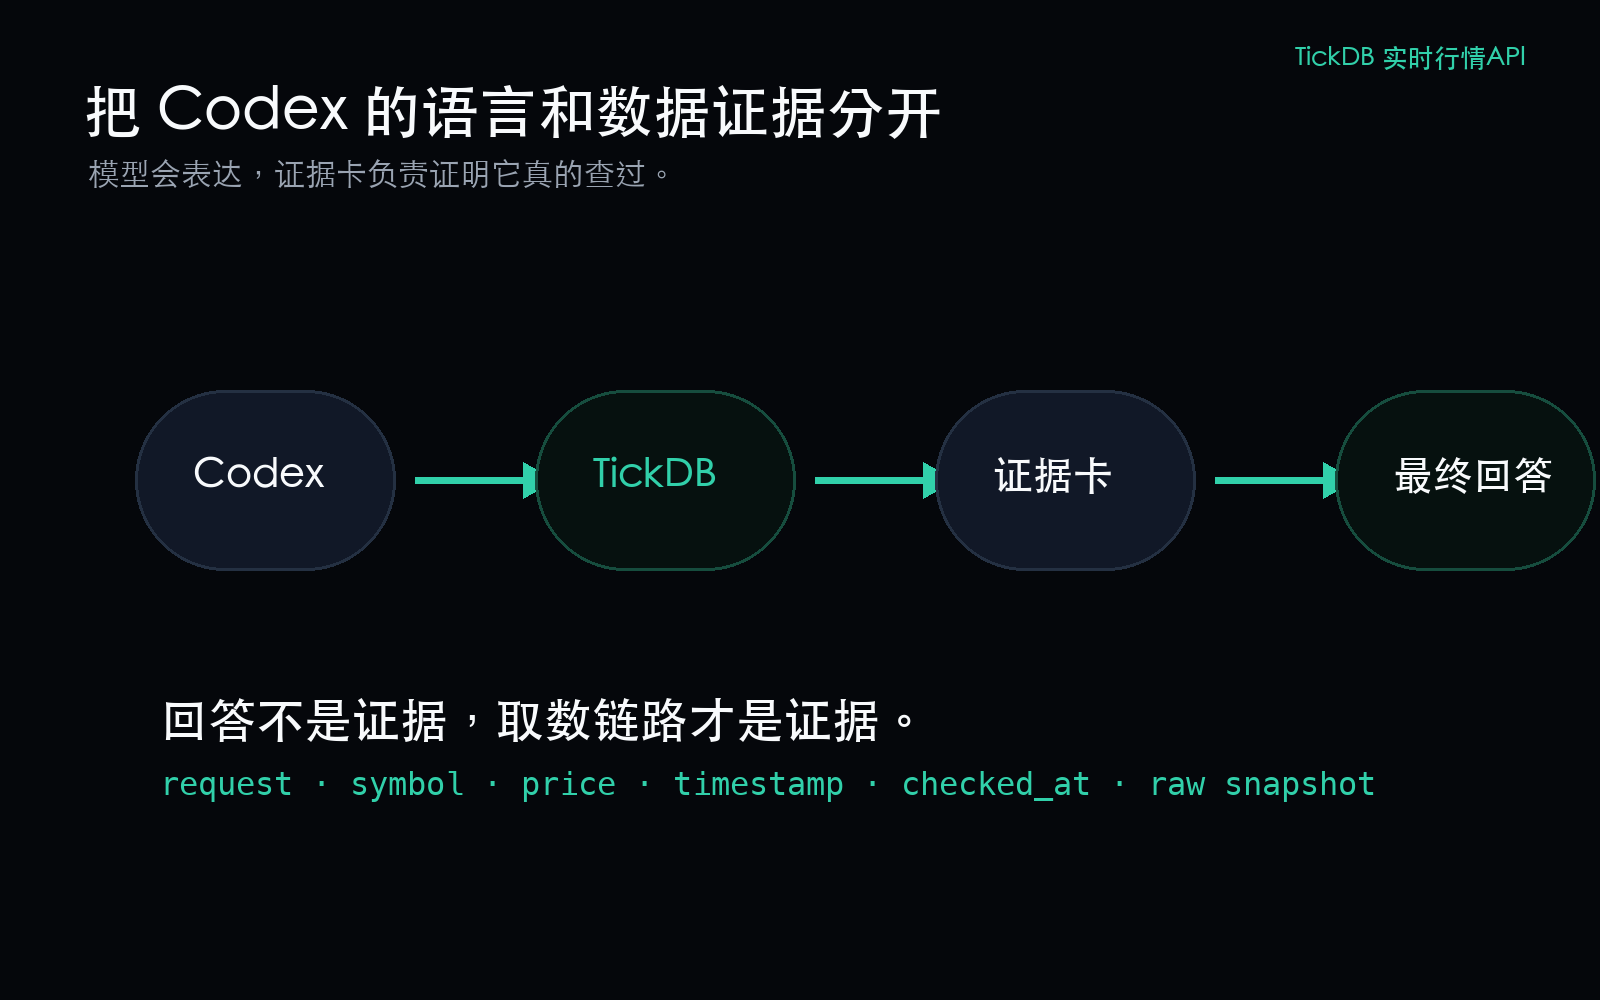
图注:Codex 负责组织语言,TickDB 负责提供可调用行情入口,证据卡负责把这次取数变成可复查记录。
我现在更倾向于把这类 AI 行情工作流拆成三层。
第一层,Codex 负责理解和表达。
它能把用户问题拆成步骤,把脚本写出来,把结果解释成人能看懂的话。
第二层,TickDB 负责真实取数。
本文用的是 REST ticker。如果在其他场景里,也可以按官方能力使用 WebSocket、MCP、CLI 或 Skill 等接入方式。不同入口的鉴权方式和字段边界要分开,不要混写。
第三层,证据卡负责留痕。
请求参数、返回字段、检查时间、原始快照、失败分支,都要能回头查。
很多人把这三层混在一起:
Codex 说出了答案,就以为它查了数据。
接口返回 200,就以为业务数据可用。
模型解释得顺,就以为结果可信。
更稳的顺序应该反过来:
先取数,再校验,再让 Codex 组织回答。
这样 Codex 的价值不是“凭空知道价格”,而是把已经取到、校验过、留过痕的数据讲清楚。
七、TickDB 在这里的合理位置
TickDB 在这篇文章里的位置,不是替 Codex 做投资判断,也不是证明某个股票该买还是该卖。
它适合作为一个可程序化调用的行情入口:让 Codex 这类工具在需要行情数据时,不靠记忆,不靠猜,而是通过明确接口拿到结构化返回。
在本文这个例子里,TickDB 提供的是 REST ticker 查询能力。脚本拿到 symbol、last_price、timestamp 等字段后,再由证据卡做校验和留痕。
如果你做的是 AI 行情助手、研究脚本、自动化复盘或监控面板,这个思路都能复用:
| 接入方式 | 更适合的场景 |
|---|---|
| REST | 脚本、服务端任务、证据卡生成 |
| WebSocket | 持续订阅、实时监控 |
| MCP | 让支持 MCP 的 AI 工具调用行情数据 |
| CLI / Skill | 轻量自动化和 AI 工作流 |
但不管入口是哪一种,核心问题都一样:
最终回答必须能回到真实取数,而不是只停留在自然语言。
八、下次看 Codex 行情回答,先问这 8 个问题
如果你准备用 Codex、Cursor、Claude Code 或其他 AI 工具接行情数据,可以用这张清单判断回答有没有证据。
| 问题 | 如果回答不上,意味着什么 |
|---|---|
它请求的是哪个 symbol? | 可能查错标的 |
返回的 symbol 是否一致? | 可能发生市场后缀或代码混淆 |
| 它调用的是哪个工具或 API? | 可能只是模型生成 |
| 原始返回有没有保存? | 事后无法复盘 |
| 价格字段是哪一个? | 可能把不同价格口径混用 |
timestamp 是多少? | 不知道价格属于哪个时刻 |
checked_at 是什么时候? | 容易混淆检查时间和行情时间 |
data 为空时怎么处理? | 可能在没有数据时继续编答案 |
这 8 个问题不是为了为难 Codex,而是为了给动态事实回答加一道闸门。
行情数据进入 AI 工具之后,最重要的不是让模型显得更懂金融,而是让它每次回答都能回到数据现场。
九、FAQ:围绕这张证据卡,再补几个问题
Q1:这篇文章为什么要提 TickDB?
因为本文讨论的不是“Codex 怎么把话说漂亮”,而是“Codex 回答动态行情事实时,背后有没有真实取数”。
TickDB 在这里只是取数入口。它提供结构化行情返回,让脚本能拿到 symbol、last_price、timestamp 这些字段,再由证据卡记录 checked_at 和原始快照。
它的作用很具体:让 Codex 不靠记忆回答 AAPL.US 的价格,而是先通过接口查一次,再把这次查询留下来。
Q2:证据卡最依赖 TickDB 返回里的哪些信息?
在本文这个 REST ticker 样本里,最关键的是三类信息:
symbol:确认返回对象是不是请求的AAPL.USlast_price:确认最终回答引用的是哪个价格字段timestamp:确认这条行情数据自身对应的时间
再加上脚本侧记录的 checked_at、raw_snapshot_path 和失败分支,才组成一张能复查的证据卡。
价格只是结果。
证据卡保存的是:
这个结果从哪里来。
Q3:如果我用 Cursor、Claude Code 或 MCP,逻辑会变吗?
工具入口会变,但证据逻辑不变。
本文用的是 Codex 工作台里的 REST 脚本,所以鉴权用的是 REST 的 X-API-Key。
如果换成支持 MCP 的 AI 工具,入口可以变成 MCP 工具调用;但你仍然要记录请求对象、返回字段、时间戳、检查时间和原始结果。
不管是 Codex、Cursor、Claude Code,还是其他 AI 工具,只要它在回答行情这种动态事实,就不应该跳过证据卡。
Q4:这套方法适合什么场景?
适合所有“AI 不能靠记忆回答”的动态事实场景。
比如:
- 让 Codex 查询股票价格
- 让 AI 工具生成行情复盘
- 让研究脚本引用某个时点的价格
- 让自动化报告写入市场数据
- 让团队排查一次行情回答的来源
这些场景里,真正重要的不是 AI 能不能说出一个顺滑答案,而是这个答案能不能追溯到一次真实取数。
Q5:TickDB 还能接哪些市场?这篇为什么没有展开?
TickDB 的产品资料里,市场类型包括外汇、贵金属、指数、美股、港股、A 股和加密货币等,多市场 symbol 规则也有对应约定。
但这篇不展开讲“覆盖清单”,因为本文的核心问题不是介绍 TickDB 全部能力,而是用 AAPL.US 这个样本讲清楚:
Codex 回答一个动态价格前,如何留下最小证据链。
换到 A 股、港股、外汇或其他市场时,文章的方法仍然可以复用,但每个市场的 symbol、交易时段、字段语义和接口返回,都要按对应文档和实测重新核对。
Q6:什么时候 Codex 不应该给确定价格?
至少这几种情况不应该给确定价格:
data为空- 返回
symbol和请求symbol不一致 last_price缺失timestamp缺失- 没有记录
checked_at - 没有保存原始返回
- 只能看到自然语言答案,却看不到取数过程
这时更好的回答不是硬给一个数字,而是说明:
本次没有拿到可核验价格。
对 AI 工具来说,知道什么时候停下来,比永远给答案更重要。
最后
下次 Codex 给你一个股票价格,不要先问它“准不准”。
先问它:
证据卡在哪里?
如果它能告诉你请求了什么、返回了什么、timestamp 是多少、checked_at 是什么时候、原始快照在哪里,这个回答至少有了可复查的基础。
如果它只能给出一个流畅的自然语言答案,没有工具调用、没有原始返回、没有字段校验,那它可能只是在说一个看起来合理的数字。
你在 Codex、Cursor 或 Claude Code 里查过行情吗?你是直接看它给出的价格,还是会去核对它有没有真正调过接口?
欢迎在评论区聊聊你的经验。
本文只讨论 Codex 工具调用行情数据时的取数证据链、字段校验和工程留痕,不构成任何投资建议。具体接口路径、字段语义和产品能力以 TickDB 官方文档与实际审核结论为准。
标签:Codex、AI查行情、实时行情API、TickDB、AAPL.US、AI Agent、MCP金融数据、行情数据证据链