自选股跨了A股港股美股,还在打开三个APP翻?盘中扫异动前,先定这五个字段
TickDB Research ·
自选股四十只,A股港股美股都有,每天早上打开三个 APP 翻一遍。有天腾讯盘中跌了 3%,又弹回来,我在外面吃饭,完全没看到。下午再打开,只看到它跌了 2%。
这个 2% 是结果,不是过程。
问题不在我没有实时数据。问题在我看到的那个数字——涨跌幅——它只告诉我一个方向,没告诉我这个方向是怎么走出来的。
同一只股票,只看涨跌幅和看开高低收加成交额,你做出的判断可以完全相反。股票池越大,这个差距越贵。
这篇文章拆三件事:
- 看清:同一只股票,为什么三个 APP 给了你三种感觉?
- 盯住:你的股票池多大,决定你该用什么级别的数据接法。
- 避开:交易日历不是可选项,是每天开盘前的第一个动作。
然后,用起来,长出来。我们一步步来。
第一步:看清——同一只股票,为什么三个 APP 给了你三种感觉
我后来把腾讯控股 700.HK 那天上午 11:43:25 的行情调出来看了一遍。最新价 422.4 港元,昨收 431 港元。跌了约 2%。
只看这个数字,你脑子里出现的是一只"在跌"的股票。注意力全在"跌了多少"上。
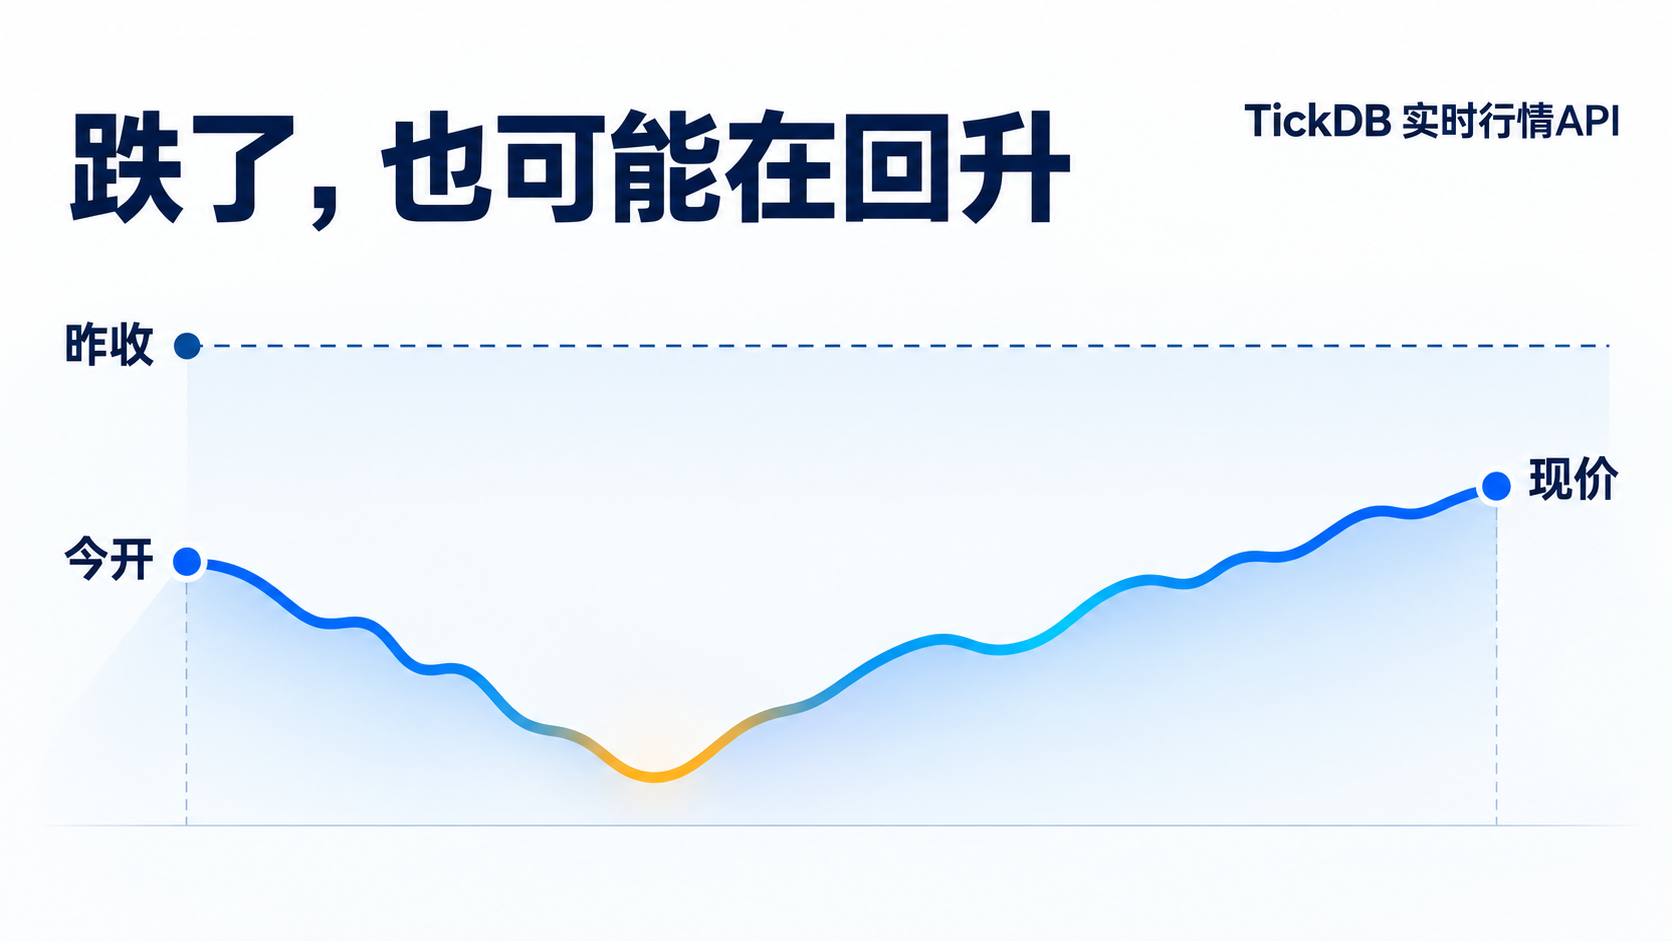
再往下看一个字段:开盘价,422 港元。最新价 422.4,比开盘还高了 0.4 港元。同一时刻,相对昨收是跌的,相对开盘是涨的。
这只是两个字段的差别。再看当日最高价 425,最低价 420——价格在 420 到 425 之间走了一个区间,最新价 422.4 落在中间偏下的位置。加上累计成交额约 41.15 亿港元,你大概能感觉到,这不是一只没人管的冷门股,盘中是有资金在动的。
| 你看的字段 | 你看到的故事 | 操作信号 |
|---|---|---|
| 只看涨跌幅 | 最新价 422.4,昨收 431,跌约 2% | 一只在跌的股票 |
| 加上开盘价 | 开盘 422,最新价 422.4,比开盘高 0.4 港元 | 盘中回暖,相对开盘转正 |
| 加上高低价+成交额 | 日高 425,日低 420,成交额约 41.15 亿港元 | 贴着日高、成交活跃的股票 |
同一组数据,三种读法。你选哪一种,取决于你手里有哪些字段。
这里要拆的底层逻辑是:涨跌幅的基准是昨收。昨收是昨天的事。 今天开盘之后,市场用新的信息重新定价,开盘价才是今天的第一个共识。最新价相对昨收跌,只说明它比昨天便宜了;相对开盘涨,说明今天买入的人比今天开盘时更愿意出价。两个判断都对,但指向不同的操作。
根据投资教育类内容的分析,涨跌幅回答的是"今天市场对这只股票的定价,相对于昨天最终共识偏移了多少";开盘价回答的是"经过集合竞价后,市场对当日走势的初步共识是什么"。这两个问题不一样,答案当然可能不一样。
同理,日高日低是今天的波动区间,成交额是今天的参与度。这四个字段各自回答一个不同的问题:
- 昨收回答:相对昨天,它动了多少?
- 开盘回答:相对今天开盘,它动了多少?
- 最高回答:今天它走到过哪里?
- 最低回答:今天它跌到过哪里?
- 成交额回答:今天有多少钱在参与?
只看涨跌幅,你只问了其中一个问题。
原文里有一句话很关键:"假如两只股票都涨了 3%,一只已经离当天高点较远,另一只还贴着高点,仅看涨幅时它们很相似,加上高低价之后,就能分开观察了。"
涨幅一样,日内位置不一样,含义完全不一样。 贴着高点的那只,说明多方在日内持续占主导;离高点较远的那只,说明盘中曾出现强劲买盘推升,但遭遇了更强的卖盘打压。这就是"结果"和"过程"的区别——涨跌幅告诉你结果,高低价告诉你过程,而过程往往比结果更能预示未来。
我后来把自己看板的字段固定下来了,就这五个:涨跌幅、开盘价、日高、日低、成交额。它们放在同一屏,同一只股票的故事才完整。
第二步:盯住——你的股票池多大,决定了你该用什么级别的数据接法
看清之后,下一个问题是:你怎么把这只股票的数据接回来。
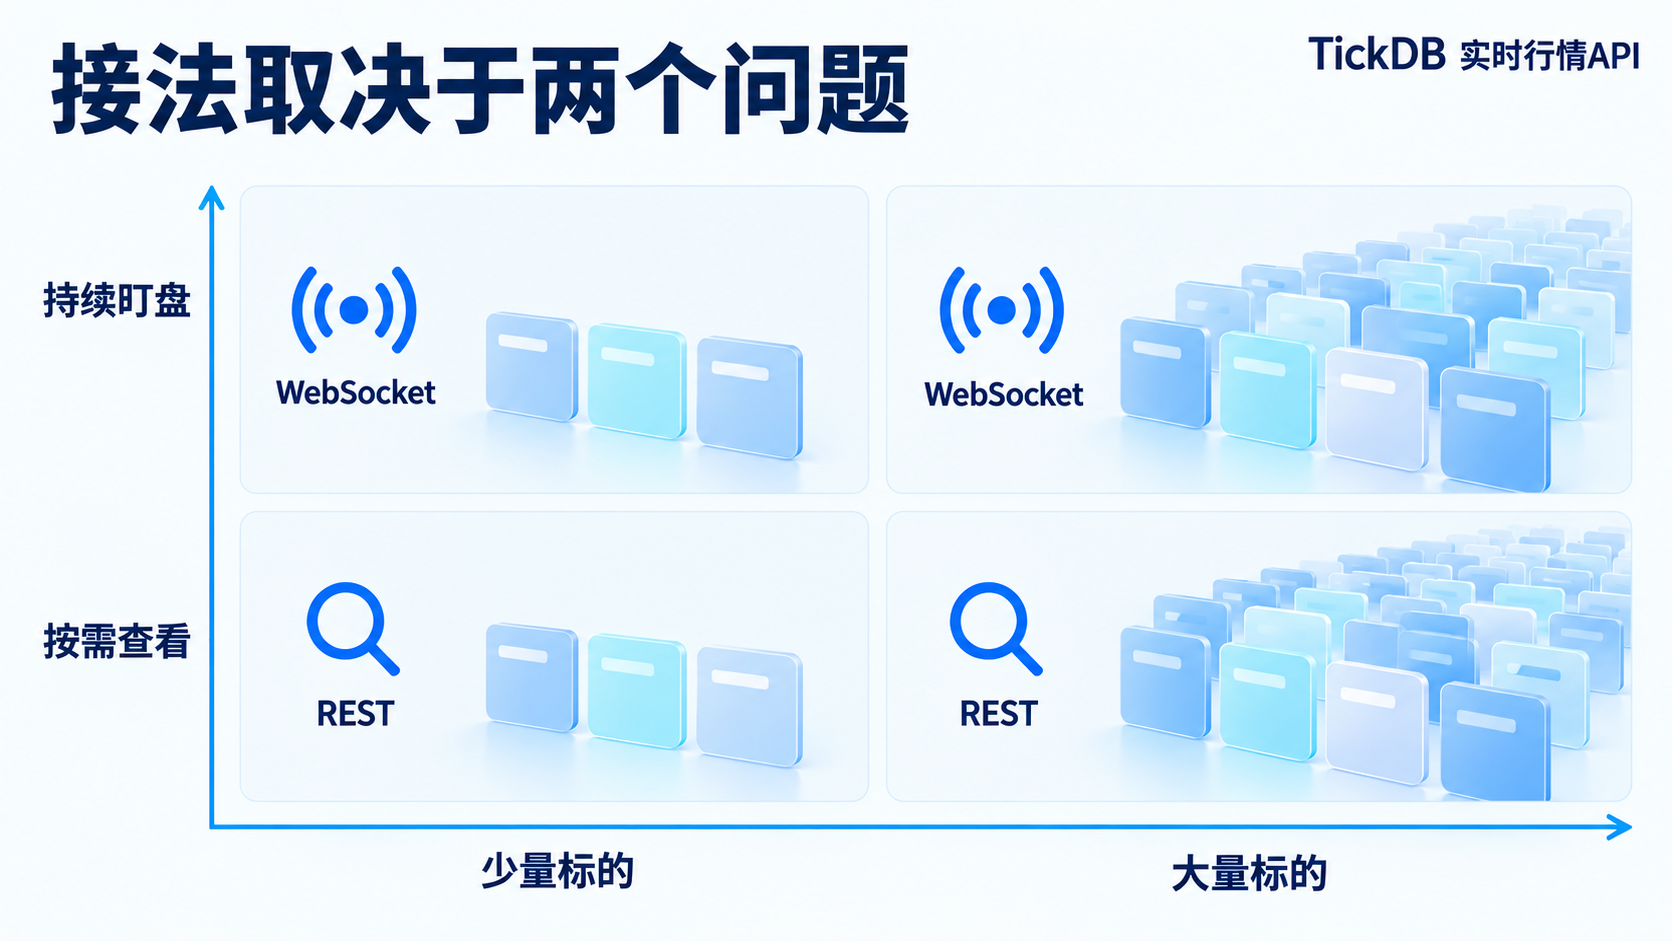
原文的核心是一张决策矩阵:股票池大小乘以更新频率,决定选哪种接口。我把它翻译成投资者能直接对号入座的语言。
你的股票池边界                更新节奏              对应接法
─────────────────────────────────────────────────────────────
30 只自选股          ──→   打开时刷新一次    ──→   普通 Ticker REST
30 只自选股          ──→   一直盯着,条件提醒 ──→   普通 Ticker WebSocket
300 只候选股         ──→   每分钟重排一次    ──→   普通 Ticker REST 分批
300 只候选股         ──→   持续盯            ──→   普通 Ticker WebSocket
发现全市场新候选     ──→   盘中一直扫        ──→   全量 WebSocket
定期扫全市场         ──→   每天扫几次        ──→   全量 REST 快照
四种场景,四种接法。你的股票池边界在哪里,工具形态就在哪里。
场景一:30 只自选股,打开看板时刷新一次
这就是普通 Ticker REST 接口的场景。像 600519.SH、700.HK、AAPL.US 这样的代码,可以放在同一批查询里。这个接口单次最多查询 50 个代码,30 只自选股一条请求就能装下。
几个市场共用查询行情、更新最新价、计算筛选条件这套代码,多加一个市场,也能沿用已有的处理流程。你不需要为每个市场单独写一套逻辑。代码格式统一了,字段结构统一了,加一个市场只是多传几个代码。
读者可直接带走的代码(批量查询三市场 ticker):
import os, requests

BASE = "https://api.tickdb.ai/v1"
HEADERS = {"X-API-Key": os.environ["TICKDB_API_KEY"]}

def get(path, params=None):
    resp = requests.get(BASE + path, params=params, headers=HEADERS, timeout=30)
    resp.raise_for_status()
    data = resp.json()
    if data.get("code") != 0:
        raise RuntimeError(data)
    return data["data"]

batch = get("/market/ticker", {"symbols": "700.HK,600519.SH,AAPL.US"})
for item in batch:
    print(item["symbol"], item["last_price"], item["prev_close"], item["quote_volume_24h"])
这里有一个实测细节:批量查询返回的字段名,三个市场是统一的。昨收字段叫 prev_close,不是 pre_close。成交额字段叫 quote_volume_24h,不是 amount。高低价字段叫 high_24h、low_24h。如果你按直觉去猜字段名,代码会报错。
场景二:30 只自选股,想一直盯着,满足条件就提醒
普通 Ticker WebSocket 能用。它支持在一个订阅消息里放多个股票代码,后面持续接收行情更新。
这里的关键差别不是"快慢",是"谁主动":
| 接法 | 谁主动 | 适合什么 |
|---|---|---|
| REST | 你去查 | 打开页面查一次,隔一段时间刷新 |
| WebSocket | 数据来找你 | 后台安静盯着,条件满足时弹出来 |
场景三:300 只候选股,每分钟用行情重排一次
批量查询仍然有用。比如在几个市场里按行业或基本面圈出 300 只,拆成 6 批请求就可以完成一轮(300 ÷ 50 = 6)。
但这里有一个成本很多人没算过:刷新越快,请求也越密。改成每 10 秒跑一轮,光这一件事就需要每分钟 36 次请求——6 批 × 每 10 秒一轮 × 6 轮。 还得给其他接口调用留点余量。刷新间隔要对照接口限流来安排。
也可以考虑用普通 WebSocket 订阅这个候选池。几百只股票能否一起订阅,要看实际的订阅额度。
场景四:要发现全市场的新候选,盘中一直扫
全量 WebSocket 更贴近这个需求。A 股、港股和美股都有各自的全量 Ticker,按关注的市场分别订阅。
做港股扫描,订阅一次 HK_Stock,先接收分批到达的市场快照,后续继续接收变化行情。工具里保留每只股票的最新状态,哪只股票有更新,就重新看看它是否满足条件。
我实际调用了一次港股全量 REST,返回了 3,325 条行情记录。但这里有一个细节:3,325 条里,type=stock 的有 3,320 条,type=indices 的有 5 条。所以"3,325 只港股股票"是不准确的,应该叫"3,325 条行情记录,含 3,320 只股票和 5 条指数"。
还有一个开发细节:全量端点返回的 symbol 是 1、10、100 这种无 .HK 后缀的格式,而批量 ticker 返回的是 700.HK。直接关联需要代码标准化。
第三步:避开——交易日历不是可选项,是每天开盘前的第一个动作
写这篇时是 10 月 5 日。我先用交易日历接口分别查了 A 股、港股和美股当天的安排。
| 市场 | 10 月 5 日 | 说明 |
|---|---|---|
| CN | trade_days: [] | A 股休市 |
| HK | trade_days: ["20261005"] | 港股交易中 |
| US | trade_days: ["20261005"] | 美股是交易日,但查询时纽约时间 01:37,尚未开盘 |
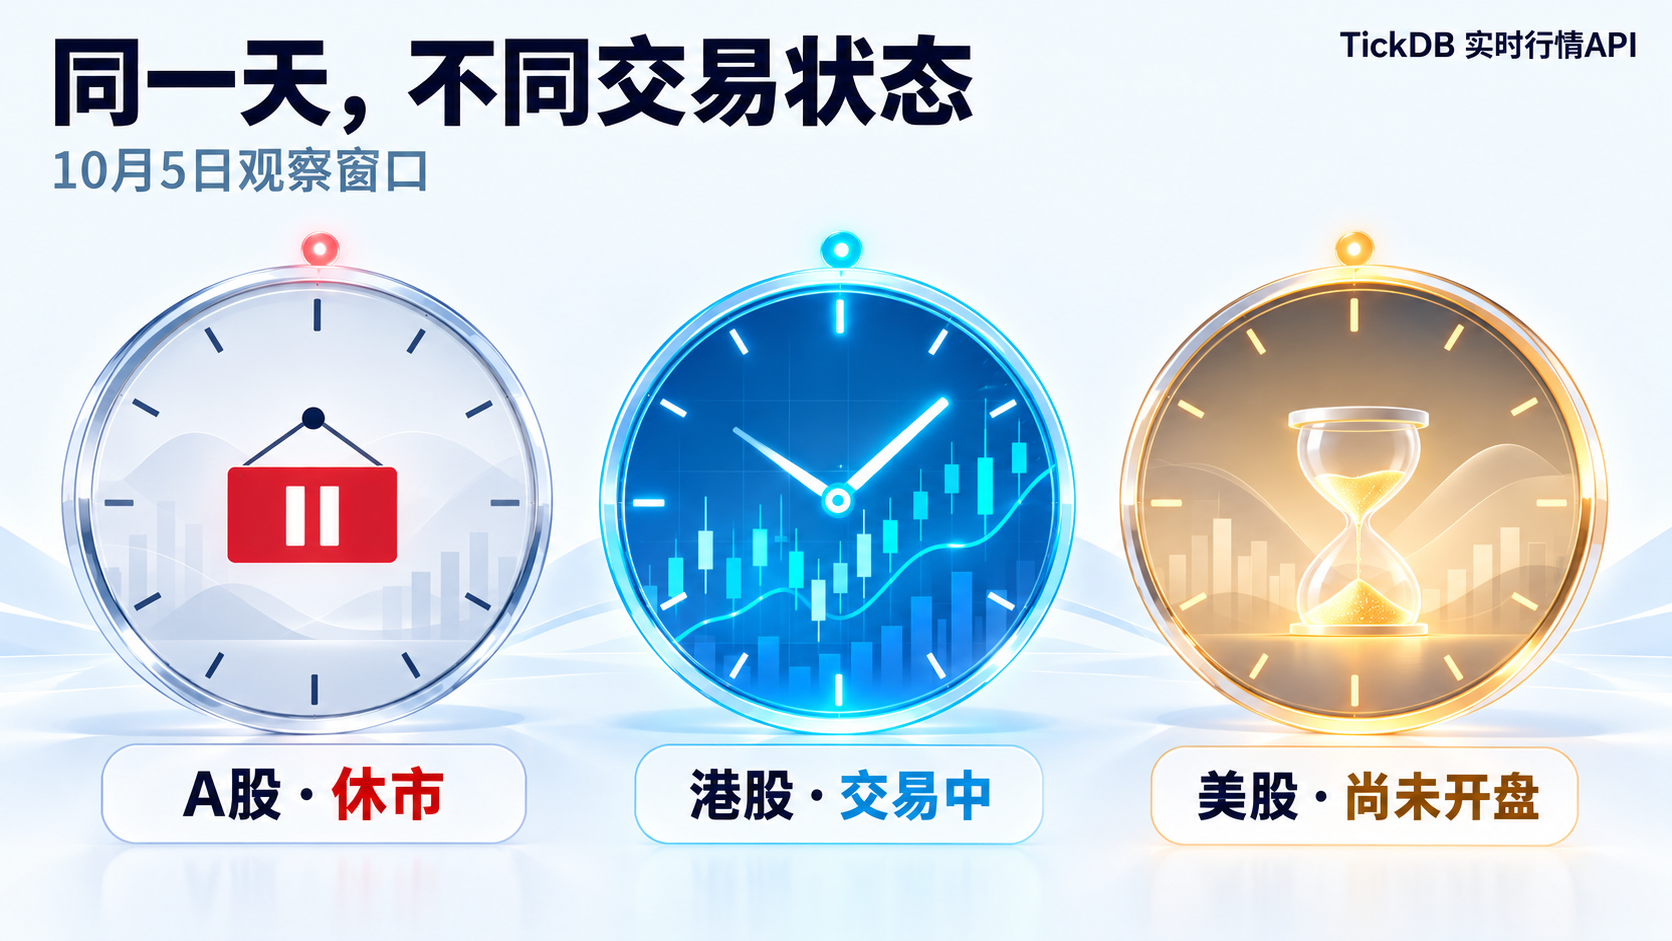
交易日不等于查询当刻正在交易。 美股是交易日,但北京时间下午 1 点 37 分,纽约还是凌晨。如果你的工具不判断这件事,它会在美股开盘前就以为"今天有实时数据",然后用上一交易日的收盘时间戳来算今天的涨跌幅。
我查了 600519.SH 在 10 月 5 日的快照。接口正常返回了数据,但时间戳是 9 月 30 日 15:30:28——上一个交易日收盘的时间。这不是错误,但它是一个陷阱:如果你不做判断,直接拿这个价格去算今天的涨跌幅,算出来的就是错的。
A 股休市、港股交易、美股尚未开盘——三个市场,三种状态。同一个"今天",含义完全不同。
读者可直接带走的代码(查询交易日历):
for market in ["CN", "HK", "US"]:
    cal = get("/market/trade-days", {
        "market": market,
        "beg_day": "20261005",
        "end_day": "20261005"
    })
    print(market, cal["trade_days"])
不处理交易日历,回测时会有四种常见陷阱:
- 用交集(inner join)会把港股在 A 股休市期间的波动删掉。你以为你在看 A 股和港股的关系,其实你只看到了两个市场都开市的那几天。
- 用前向填充(forward fill)会把非交易日填成有交易。你以为你在看连续的价格序列,其实你看到的是被"造"出来的数据。
- 按工作日遍历。A 股休市、港股交易的日子被当成没有数据,信号时间就偏了。
- 半日市没处理。港股圣诞节前夕、A 股春节前夜,下午的数据缺失或信号错误。
这四种陷阱,每一种都来自同一个根因:你用了同一份日历,管两个不同的市场。
多市场工具的第一个模块,不是行情,是日历。
每天准备开始扫描
       │
       ▼
查交易日历:各市场今天有没有交易?
       │
       ├── 休市 ──→ 暂停盘中扫描和提醒,页面保留最近一次行情,标上更新时间
       │
       └── 交易 ──→ 按各自交易时段安排刷新
美股还有一层:盘前盘后。常规交易时间与国内有 12 到 13 小时时差,多数重大消息往往在盘前盘后发布,那是价格异动的高发期。盘前盘后交易流动性低、波动性高、买卖价差扩大,可能短时间内出现不可持续的夸张价格。如果你的工具不区分"常规交易"和"盘前盘后",它会把不同时段的价格混在一起算。
第四步:用起来——提醒怎么发,比接什么数据更值得花心思
接上数据之后,最容易想到的筛选条件是涨跌幅。动了多少,谁排在前面,一眼就能看懂。但只按涨跌幅排一个榜单,能看到的东西还是少了点。
Ticker 里还有开盘价、昨收、当日高低价、累计成交量和成交额,这些字段可以给价格变化补上背景。上面腾讯的例子已经展示了,同一只股票加上这些字段之后,判断会变。
更进一步的用法是:盘中把同一只股票前后两次的累计值留住,看这几分钟新增了多少成交量、成交额。
我实际拉了一次腾讯 700.HK 的 1 分钟 K 线。10 月 5 日港股交易中,13:08 到 13:12 这五分钟的成交额是 33,840,912 港元,接下来的 13:13 到 13:17 是 57,741,760 港元,增加了约 70%。
价格没怎么动,但成交额突然放大。 这就是一个可以写进提醒的现象。某只股票刚进入价格筛选条件,又出现这样的变化,就可以把两个现象一起写进提醒里。
读者可直接带走的代码(计算 5 分钟成交额变化):
from decimal import Decimal

bars = get("/market/kline", {
    "symbol": "700.HK",
    "interval": "1m",
    "limit": 60,
    "adjust": "none"
})["klines"]

# 过滤掉未完成的最后一根
complete = bars[:-1]
for i in range(0, len(complete) - 4, 5):
    part = complete[i:i+5]
    total = sum((Decimal(b["quote_volume"]) for b in part), Decimal(0))
    print(f"窗口 {i//5+1}: {total}")
比起只弹出一个股票代码,这样的提醒有更多可看的内容。它不是在替你做判断,是把几个现象摆在一起,留给你自己决定要不要往下看。
不过,成交额本来就会受到公司体量和交易活跃程度的影响。大公司的成交额高,很常见;一只股票今天成交多,也要和它平时的情况比较。比如上午十点的累计成交额,可以和前几天同一时间放在一起看,才更容易判断是不是放量。这里就可以接 K 线数据,把当前的量额放回历史里看。
拉分钟 K 线时有一个细节:最后一根可能还在形成中,计算成交额变化时应该排除它,否则你拿到的是一段还没结束的数据。还有,港股中午有午休,按顺序每五根一组求和时,跨午休的那一组不是连续五分钟,不能用来比较。
股票池跨了几个市场时,成交额还得看币种。人民币、港元、美元放在同一列里,只排数值大小就容易看错。看板里标明币种,跨市场比较前再统一换算,读起来会清楚些。涨跌幅是比例,不受币种影响;但成交额是绝对金额,不换算就没法比。
还有一点容易被忽略:同一只股票可能连续更新很多次,条件刚满足时提醒一次,往往就够了。程序重连后,再把市场快照接起来,继续更新股票池。这些小处理做好,工具才能在盘中安静地帮人盯着。
顺便说一句,提醒的可靠性也是一个问题。2025 年 11 月,有用户在东方财富股吧发帖说:"今天东方财富居然没有推送消息了,一早上只有 2 条消息。"连大 APP 的推送都不一定可靠,你自己做的工具,更应该把"提醒有没有发出去、有没有重复发"这件事想清楚。
第五步:长出来——从一条提醒开始,慢慢长成你自己的看板
选股工具做到这里,就开始有了自己的用法。
| 你的阶段 | 工具形态 | 核心动作 |
|---|---|---|
| 自选股几十只 | 围绕熟悉的公司设置提醒 | 价格、日内位置、成交活跃度 |
| 候选池几百只 | 把价格、日内位置、成交活跃度放在一起重排 | 批量查询 + 条件筛选 |
| 扫全市场 | 用全量行情不断发现新名字 | 全量订阅 + 候选池补充 |
也不必一开始就把所有条件都堆进去。先挑一个自己确实关心的现象,把提醒做得有用,再慢慢补充背景。
最后呈现给用户的,可以是一句具体的话:
这只股票进入了设定的涨幅区间,目前接近日内高点,最近五分钟的成交额也高于前五分钟。
至于它是否值得继续研究,用户可以带着这些线索往下看。
用起来以后,还可以把这些提醒留下来,过一阵子再回看。提醒太频繁,就收紧一点条件;某个行业想多看几眼,就加进候选池。个人开发者做自己的看板,研究团队做内部筛选工具,都可以从一个具体的小需求开始,边用边改,慢慢做成顺手的样子。
你现在的数据源,敢不敢让你把"涨跌幅、开盘价、日高日低、成交额"这五个字段放在同一屏里看一眼?
不用写完整代码。先查第一个:你自选股里那只今天跌得最多的票,它的最新价,比今天的开盘价高还是低。
FAQ
Q1:只看涨跌幅为什么不够?
A:涨跌幅的基准是昨收,它只回答"相对昨天动了多少"。开盘价回答"相对今天开盘动了多少",高低价回答"今天走到过哪里、跌到过哪里",成交额回答"今天有多少钱在参与"。只看涨跌幅,你只问了其中一个问题。同一只股票,加上其他字段,判断可能完全相反。
Q2:多市场自选股,最少需要哪些字段?
A:涨跌幅、开盘价、日高、日低、成交额。这五个字段放在同一屏,同一只股票的故事才完整。涨跌幅告诉你结果,开盘价告诉你起点,高低价告诉你过程,成交额告诉你参与度。
Q3:交易日历到底有多重要?
A:不处理交易日历,你的工具会在一个没有交易的市场里持续轮询,浪费请求;或者在应该有提醒的时候静默。更隐蔽的风险是,回测时如果"按工作日"遍历,A 股休市但港股交易的日子会被当成没有数据,信号时间就偏了。多市场工具的第一个模块,不是行情,是日历。
Q4:我该选 REST 还是 WebSocket?
A:看你想要"谁主动"。REST 是你去查,适合打开页面查一次、隔一段时间刷新。WebSocket 是数据来找你,适合后台安静盯着、条件满足时弹出来。30 只自选股,REST 一条请求就能装下;想持续盯盘,WebSocket 更合适。
Q5:TickDB 能帮我做什么?
A:TickDB 为开发者和 AI 应用提供统一的全球行情数据接口,让团队通过一套接入获取多市场实时与历史数据,更快构建行情、分析和监控产品。在这个场景里,它的价值在于:一套 API 覆盖 A股、港股、美股,字段结构统一(prev_close、quote_volume_24h、high_24h 这些字段名三个市场一致),支持 REST 和 WebSocket,并且可以通过 MCP、Skill、CLI 让 AI Agent 直接调用结构化市场数据。你不需要为每个市场单独写一套逻辑,加一个市场只是多传几个代码。
Q6:我不是开发者,能用吗?
A:这篇文章介绍的是行情 API 的应用思路。如果你不写代码,可以把这个思路带给你的开发同事,或者用支持 API 接入的看板工具。关键是先想清楚:你的股票池多大,想多快知道变化,需要哪些字段。想清楚这三个问题,工具选型就不容易错。
参考资料
- 《自选股越来越多,A 股、港股、美股的行情怎么接?》,TickDB 官方,2026 年 10 月。
- TickDB 四项实测报告(2026-10-05):三市场交易日历、批量 ticker 字段、港股全量快照、腾讯 1 分钟 K 线。
- 投资教育类内容中关于涨跌幅、开盘价、高低价、成交额的分析框架,2020-2026 年。
- 《Hands-On Data Analysis with Pandas》中关于 forward-fill 处理非交易日的说明。
- 东方财富股吧用户关于推送缺失的讨论,2025 年 11 月。
- 老虎证券、富途牛牛用户关于跨市场切换体验的讨论,雪球、社区论坛。
- 港交所、上交所交易规则公开文件。
本文仅介绍行情 API 的应用思路。文中股票、行情样本及筛选条件用于演示,不构成投资建议或任何证券买卖推荐。